2 Empirische Modelle
Bei der empirischen Modellierung wird ausgehend von einem oder mehreren Datensätzen versucht, einen funktionalen Zusammenhang zu bestimmen, der diese Daten ausreichend gut reproduziert. Dabei ist es streng genommen unerheblich was der Datensatz beschreibt. Informationen, die über die Daten (Zahlen) hinausgehen, werden bei empirischen Modellen im allgemeinen nicht berücksichtigt.
2.1 Parameteranpassung
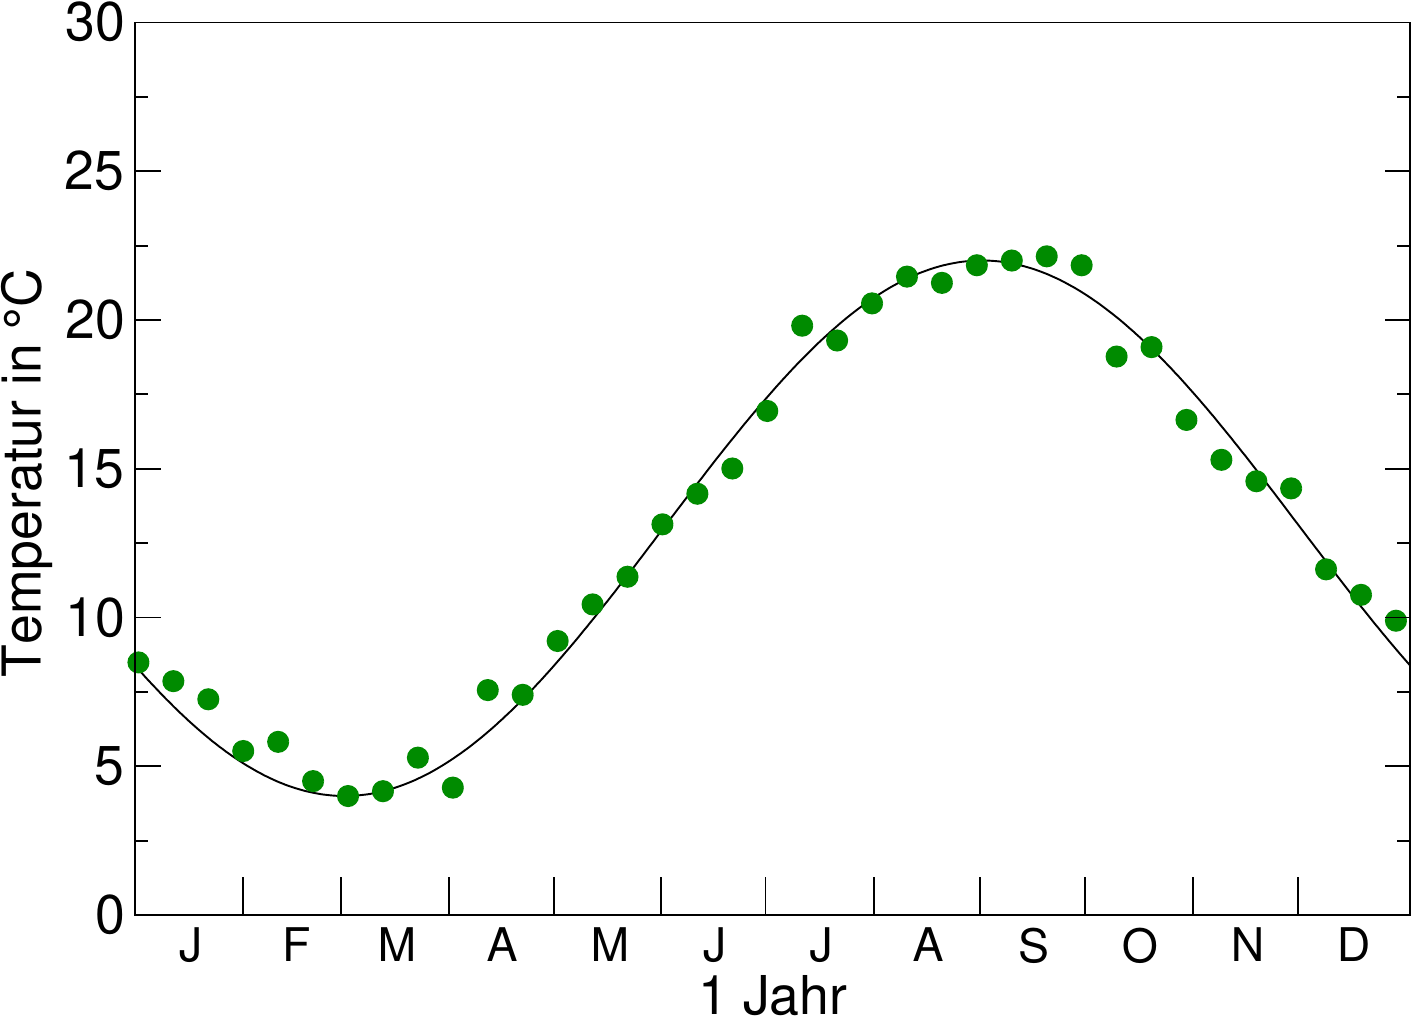
Bei der Parameteranpassung wird eine Funktion vorgegeben und die Parameter der Funktion anhand der Messdaten bestimmt. Es seien z.B. folgende Werte für die Wassertemperatur an der Nordseeküste gegeben (Abbildung 2.1):
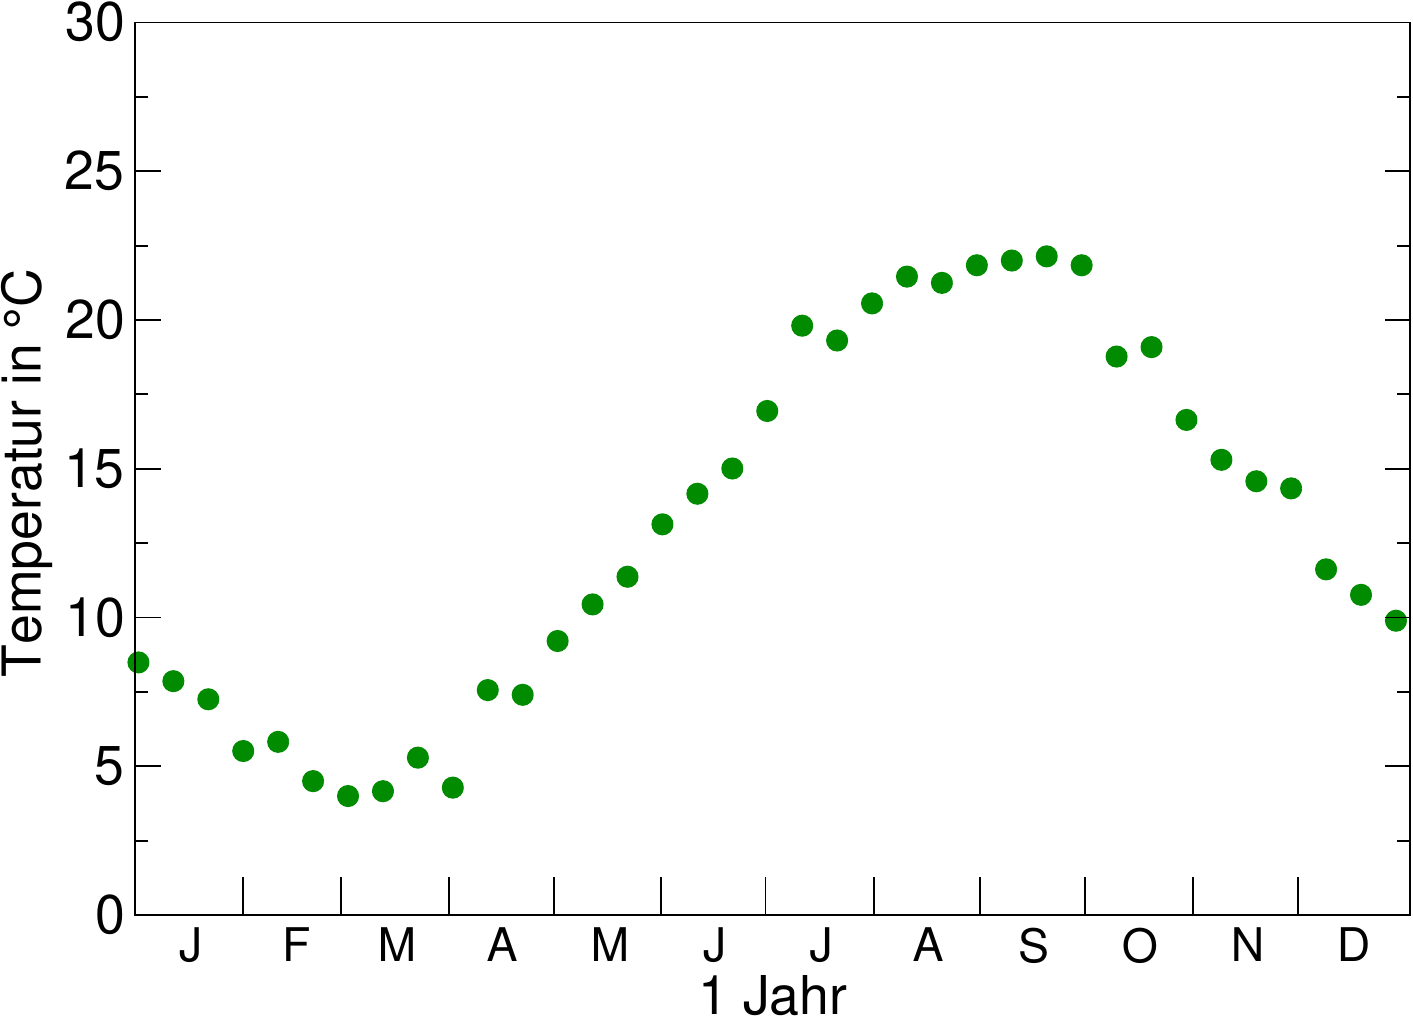
Diese Werte sollen nun durch eine Kosinusfunktion approximiert werden. Aus der Grafik erkennt man, dass der kälteste Zeitraum Mitte Februar bis Mitte März ist. Wir nehmen als kältesten Tag den Tag 60 an. Die kälteste gemessene Temperatur beträgt ca. \(4\,° C\), die wärmste ca. \(22\,° C\). Die Temperaturdifferenz beträgt somit\(18\,° C\), und die mittlere Temperatur ca. \(13\,° C\). Die Kosinusfunktion soll nun so verändert werden, dass sie zu den Daten passt:
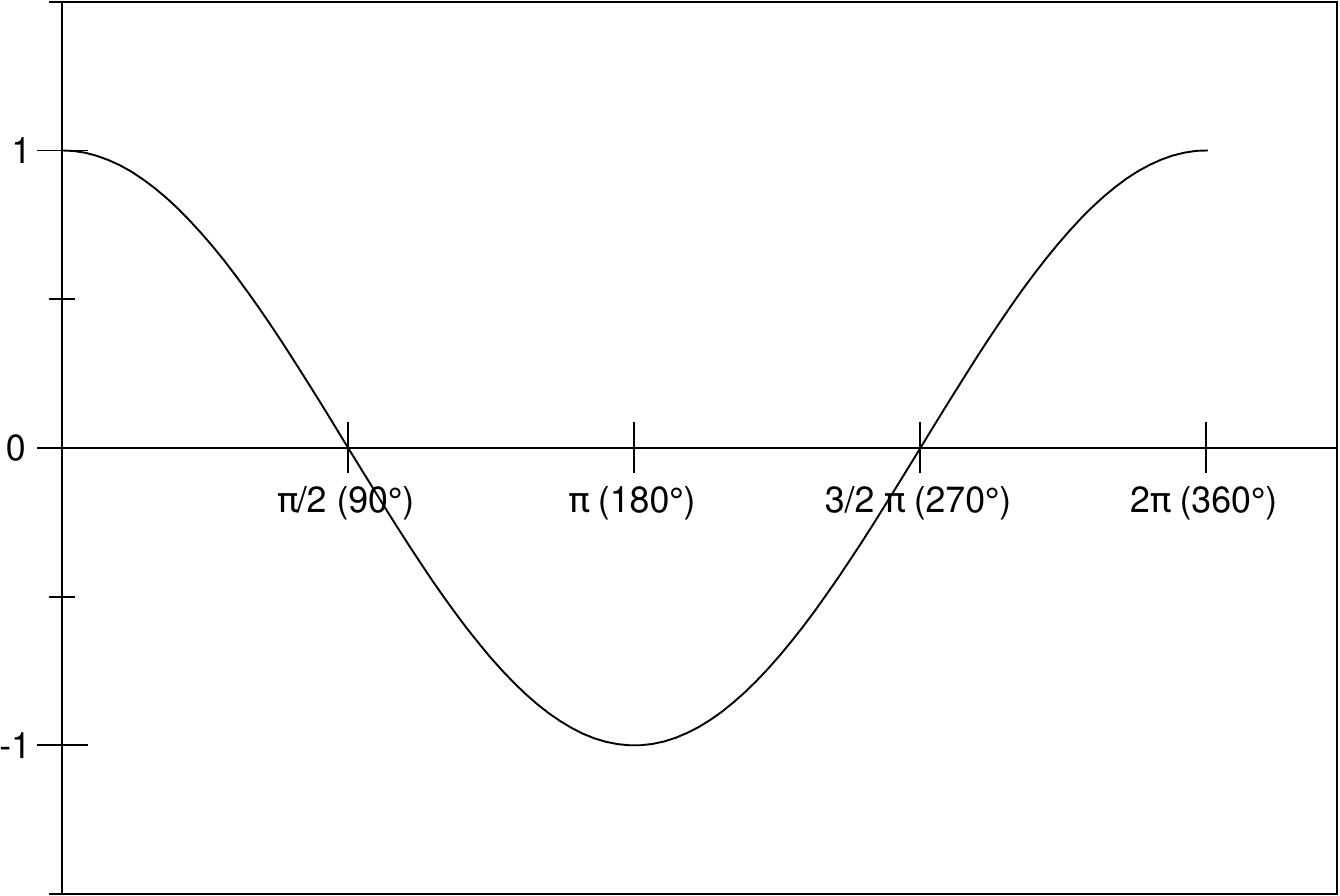
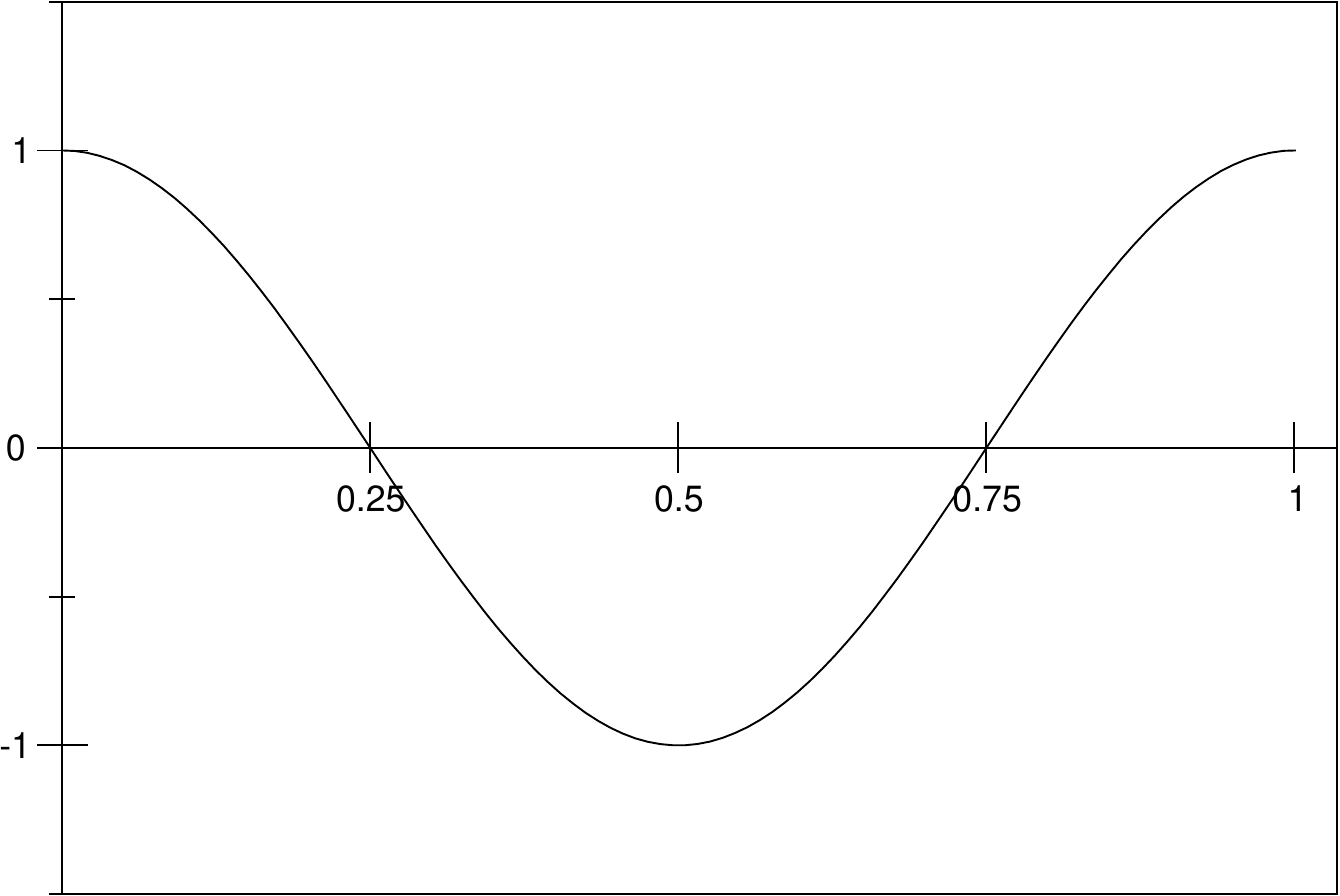
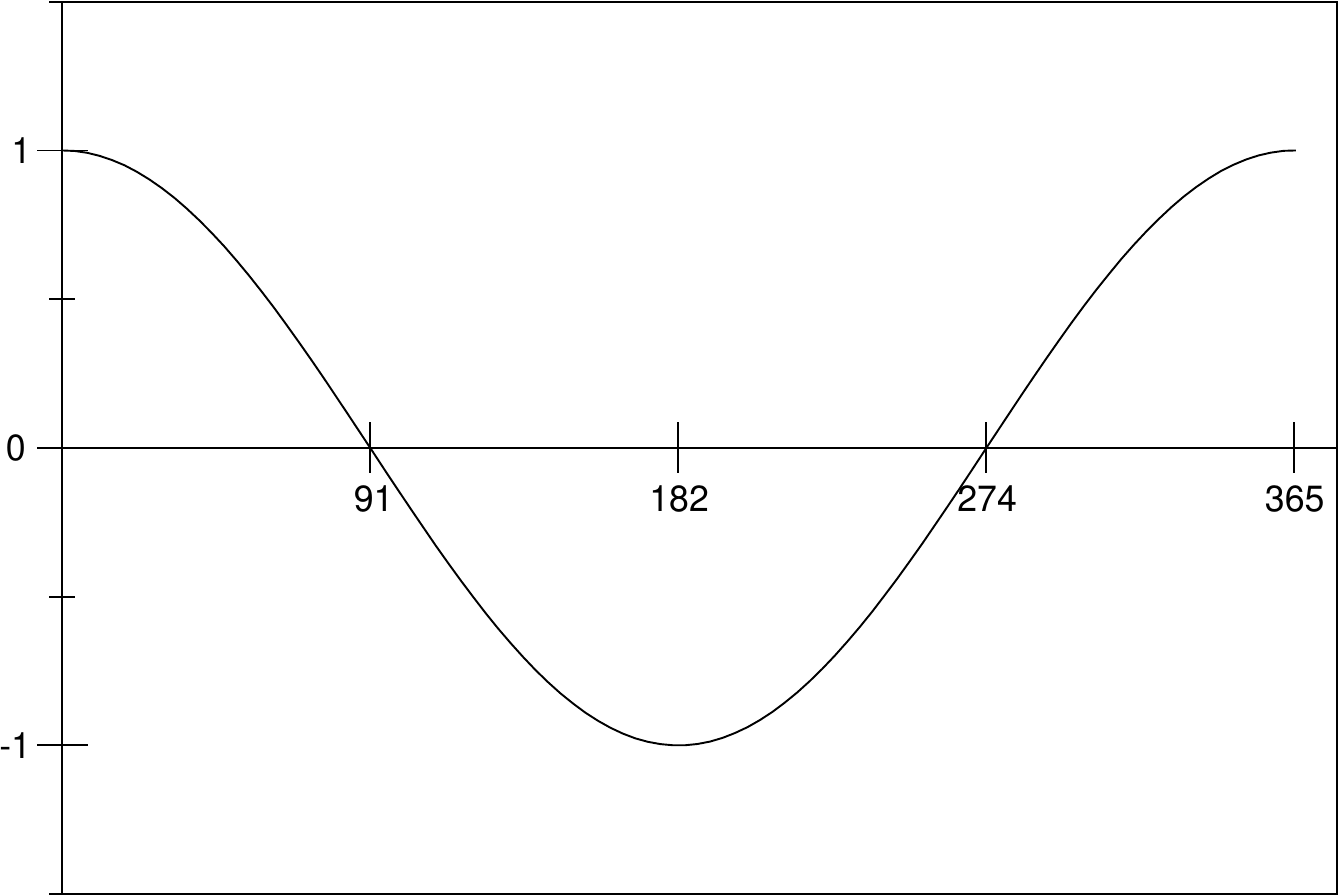
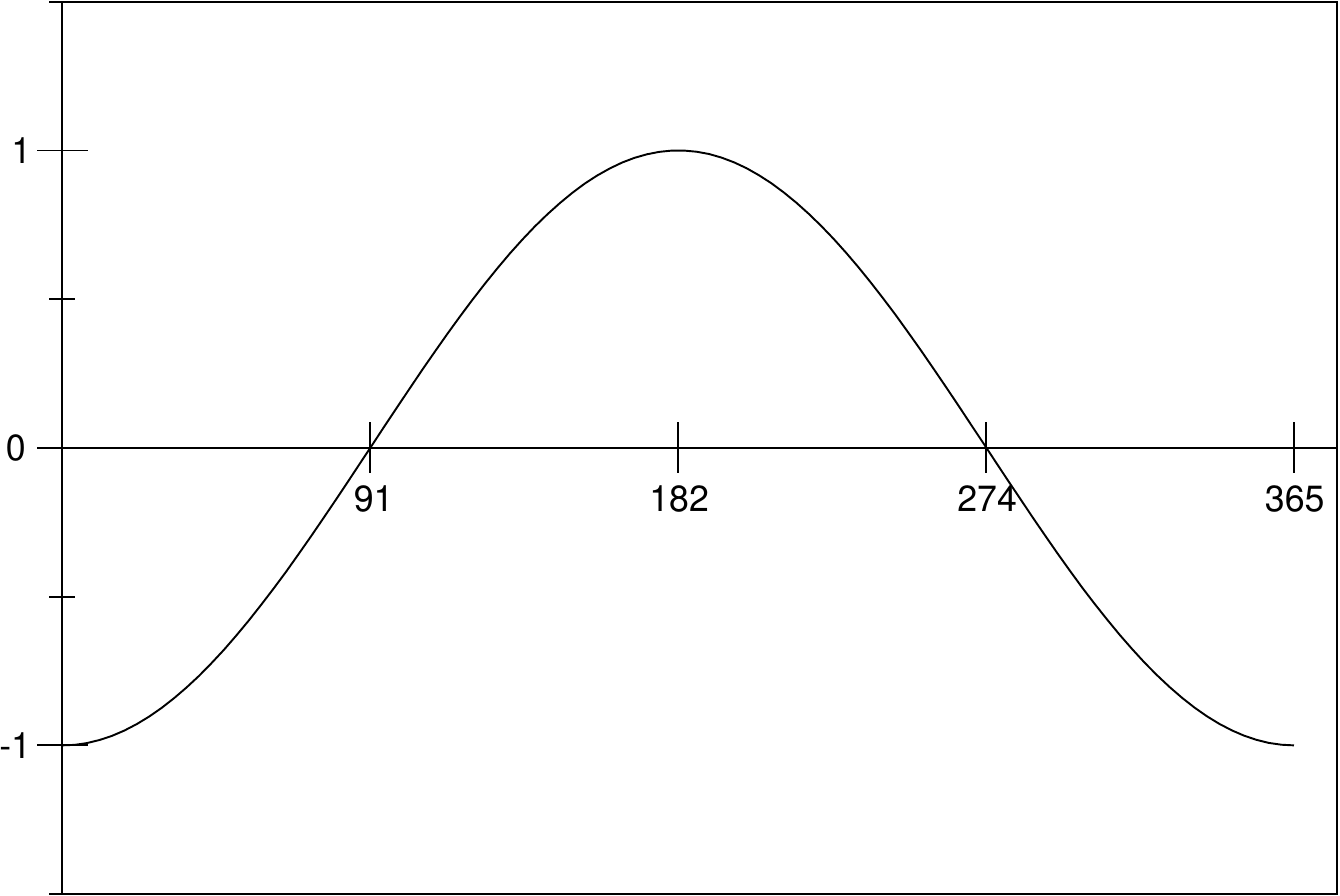
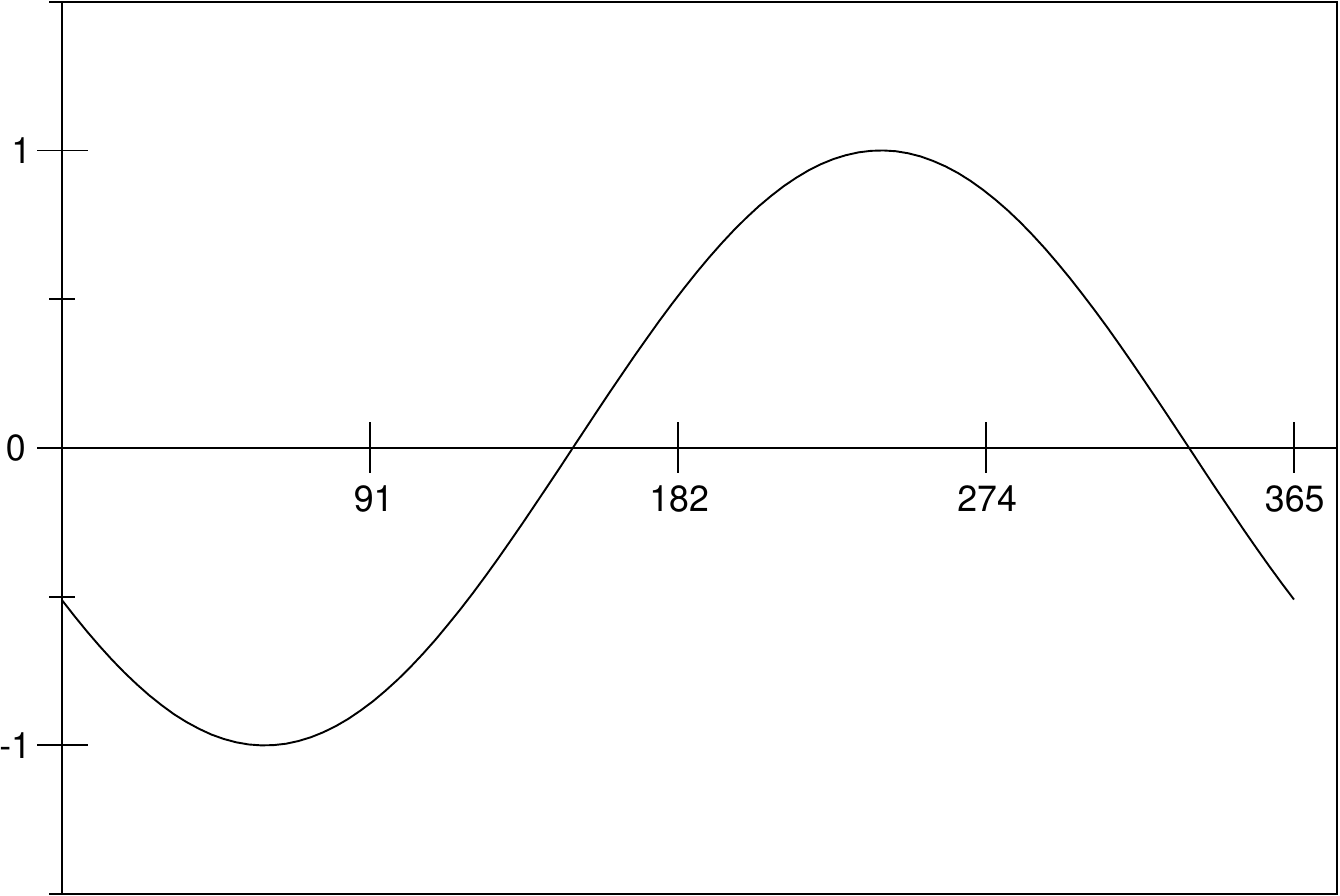
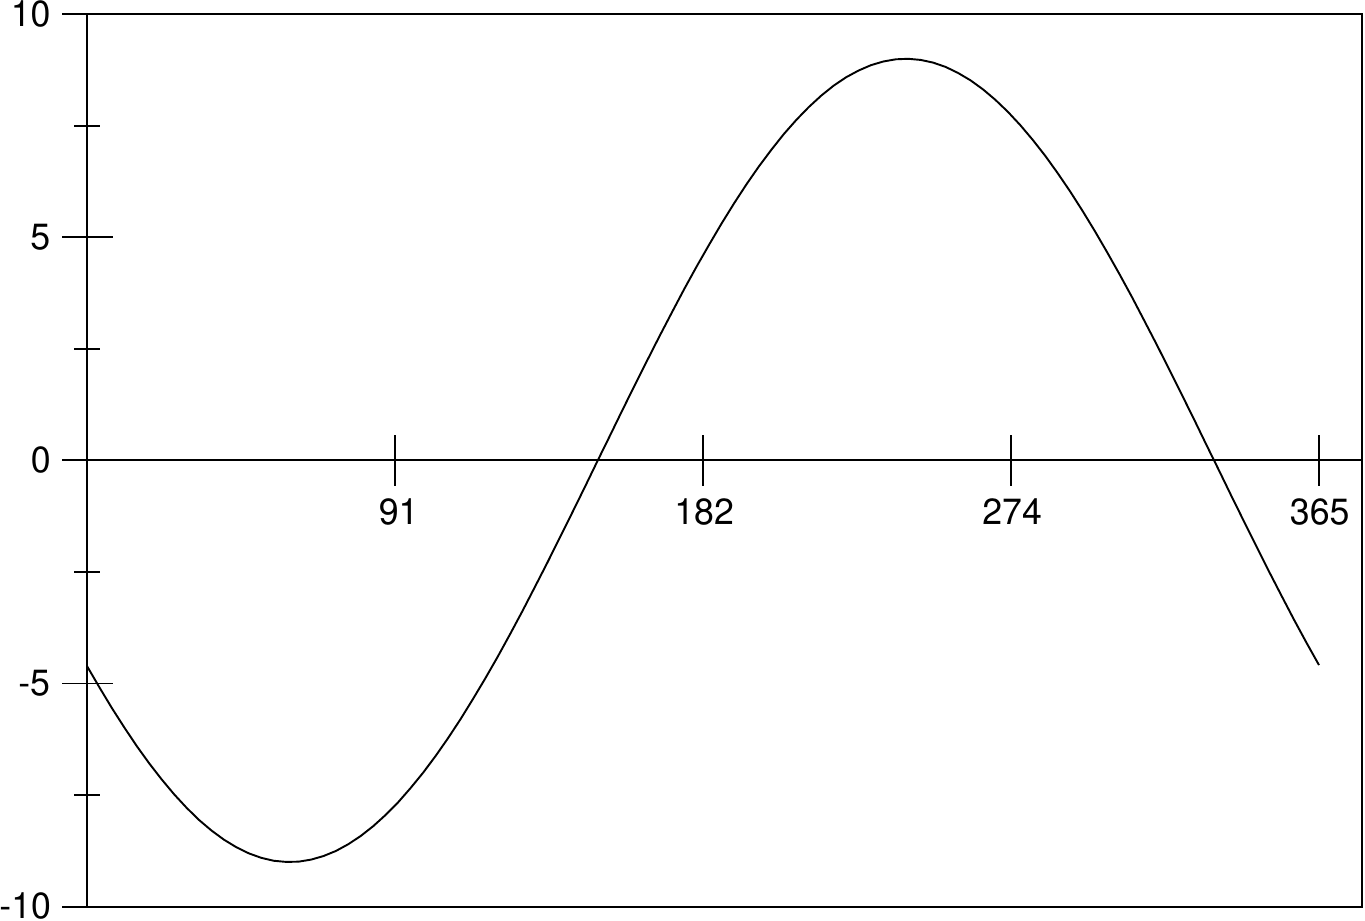
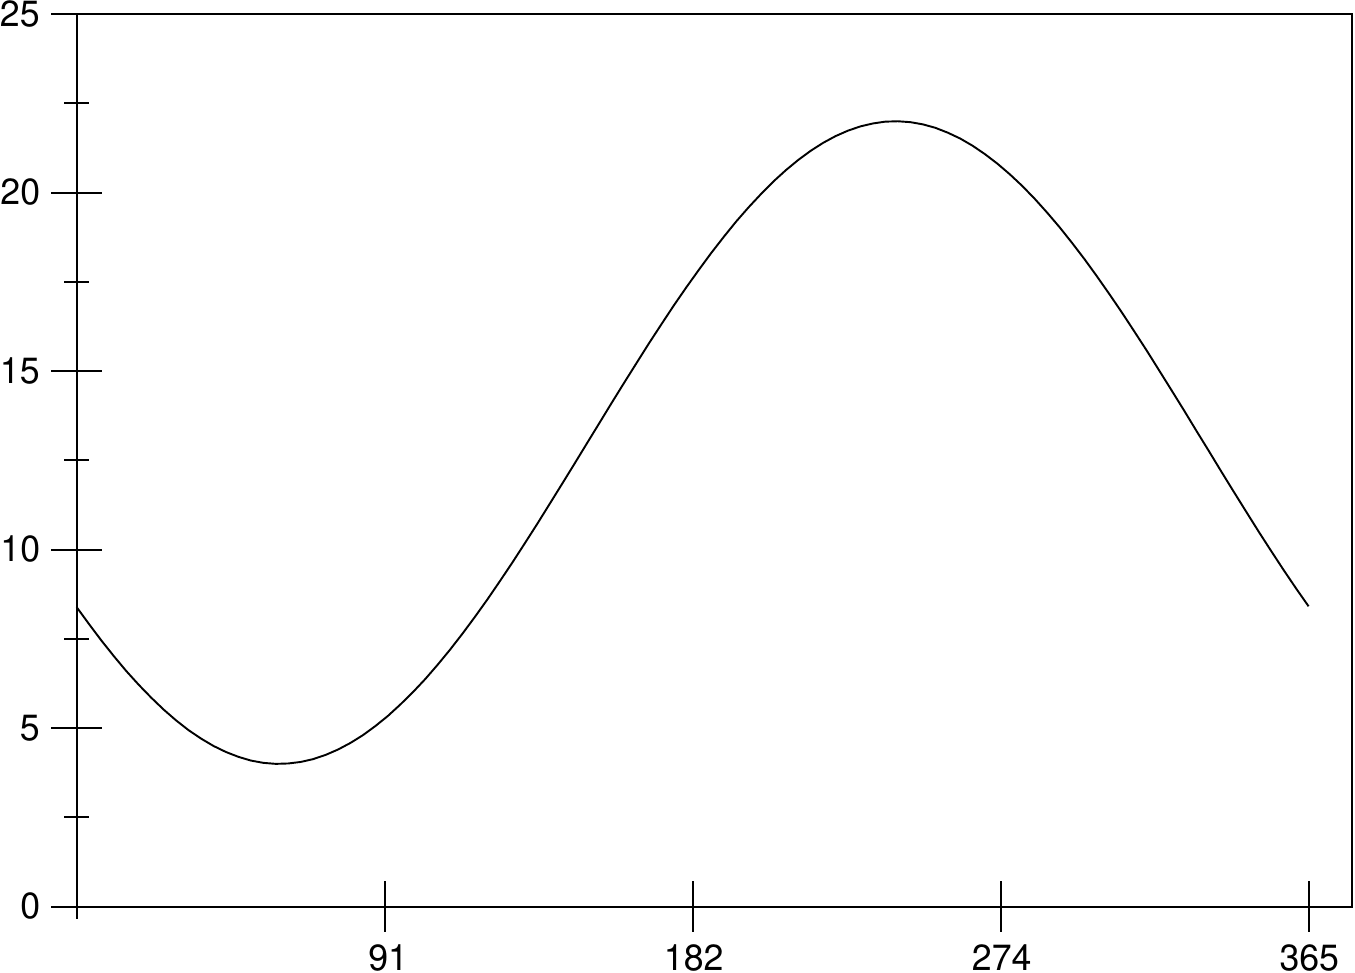
Man erhält so eine Kurve, die recht gut zu den Daten passt (Abbildung 2.2). Es bleibt die Frage offen, ob es eine bessere Anpassung gibt. Wenn man weiß, wie es geht, können die Zwischenschritte natürlich weggelassen werden.
2.2 Lineare Regression
Im vorherigen Beispiel haben wir die Parameter der Kosinuskurve anhand weniger Charakteristika, wie die Lage der Extrema bestimmt. Im folgenden wird ein Verfahren beschrieben, dass die Anpassung einer Geraden an gegebene Messwerte unter Berücksichtigung aller Messwerte erreicht. Später werden wir sehen, dass das Verfahren auch für die Kosinusfunktion funktioniert.
Die lineare Regression ist ein statistisches Verfahren, mit dem versucht wird, eine beobachtete abhängige Variable durch eine oder mehrere unabhängige Variablen zu erklären. Bei der linearen Regression wird dabei ein lineares Modell angenommen. Im einfachsten Fall ist das lineare Modell eine Gerade \(y=m\cdot x +b\) mit der unabhängigen Größe x und der abhängigen Größe y. Zu gemessenen Daten der Form \((x_i,y_i)\) werden dann die Werte für m und b bestimmt, so dass die Gerade die Daten möglichst gut beschreibt.1
2.2.1 Beispiel: Wachstum einer Bohnenpflanze
Für das Wachstum einer Bohnenpflanze seien folgende Messwerte für die Zeit in Tagen seit der Pflanzung und die zu dieser Zeit gemessene Höhe der Bohne gegeben:
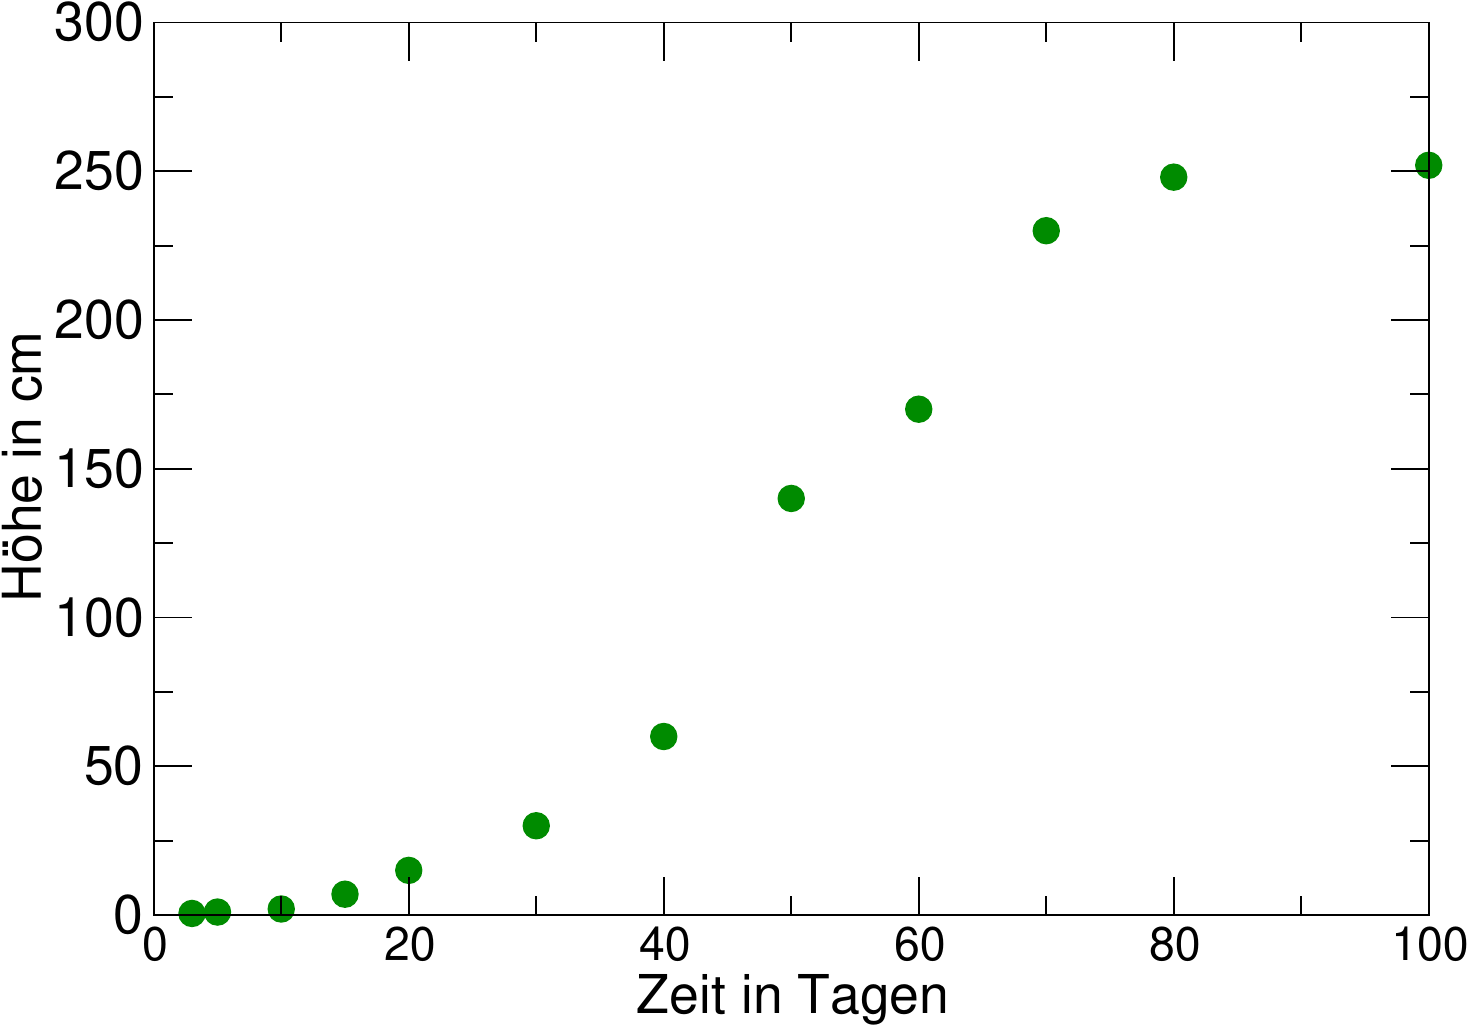
In Abbildung 2.3 erkennt man, dass im Bereich zwischen dem 20. Tag und dem 70. Tag wahrscheinlich ein linearer Zusammenhang zwischen der Wachstumszeit und der Wachstumshöhe besteht. Diesen Zusammenhang kann man durch eine Geradengleichung beschreiben:
Die Zeit t ist hier die unabhängige Größe, die Höhe \(y\) der Bohne die abhängige Größe. Man schreibt für die Zeit meistens \(t\) statt \(x\). Wir wollen nun \(m\) und \(b\) bestimmen. Uns interessiert insbesondere \(m\), die Steigung der Geraden. Sie ist ein Maß für die Wachstumsgeschwindigkeit. Eine solche Gerade kann man z.B. erhalten, wenn man zwei beliebige Punkte in diesem Bereich miteinander verbindet. Handelt es sich tatsächlich um einen linearen Zusammenhang und sind die Messungen nicht fehlerbehaftet, so kann man so die Steigung und damit die Wachstumsgeschwindigkeit erhalten. Liegen aber nicht alle Punkte auf dieser Geraden, so wird die Lage der Geraden von der Wahl der Punkte abhängen.
In der Realität wird aber weder das Wachstum exakt einem linearen Zusammenhang folgen (Bohnen wissen gar nicht, was das ist) noch wird man die Höhe derart exakt messen. In Abschnitt 2.2.2 wird daher ein Verfahren vorgestellt, eine Gerade zu bestimmen, die allen Punkten in diesem Bereich Rechnung trägt.
Aber nehmen wir mal beispielsweise die Gerade, die durch die Punkte bei \(t=20\) und \(t=70\) läuft, dann gilt:
Auflösen ergibt \(m= 4.3\) und \(b= -71.0.\)
Man kann die Steigung \(m\) auch erhalten, indem man ein Steigungsdreieck betrachtet:
Im betrachteten Zeitintervall wächst die Bohne also \(4.3\,cm/Tag\).
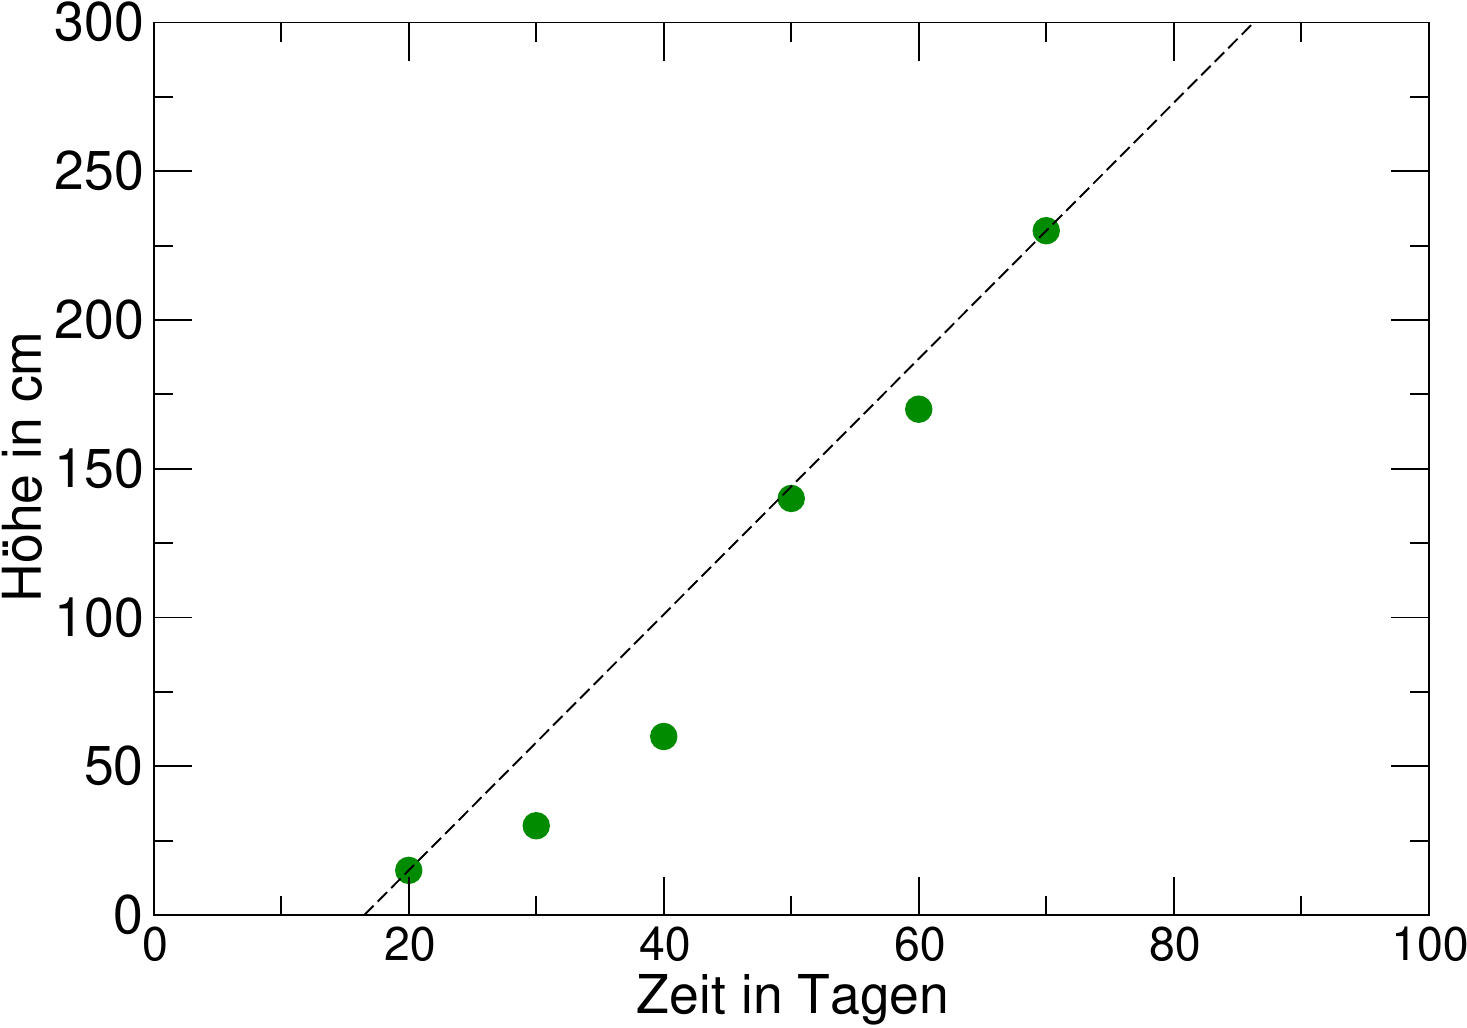
Die Methode, nur zwei Punkte zu berücksichtigen, ist natürlich falsch, da sich Messfehler und Abweichungen in diesen Punkten stark auf die Lage der Geraden auswirken. Besser ist es alle Punkte zu berücksichtigen, die im Bereich des linearen Wachstums liegen. Hierzu gibt es die Methode der kleinsten Quadrate auch lineare Regression genannt.
2.2.2 Lineare Regression oder Methode der kleinsten Quadrate
Seien \(t_1<t_2< \cdots <t_n\) die \(n\) Zeitpunkte, an denen die \(n\) Messwerte \(y_1,y_2, \cdots ,y_n\) gemessen wurden. Der Datenbereich des Beispiels aus Abschnitt 2.2, in dem lineares Wachstum angenommen wird, ist durch
gegeben.
Es soll nun eine Gerade \(y(t) = m\cdot t + b\) so bestimmt werden, dass die Summe der Quadrate der Abweichungen von Messdaten und Geraden (Abbildung 2.5) minimal wird.
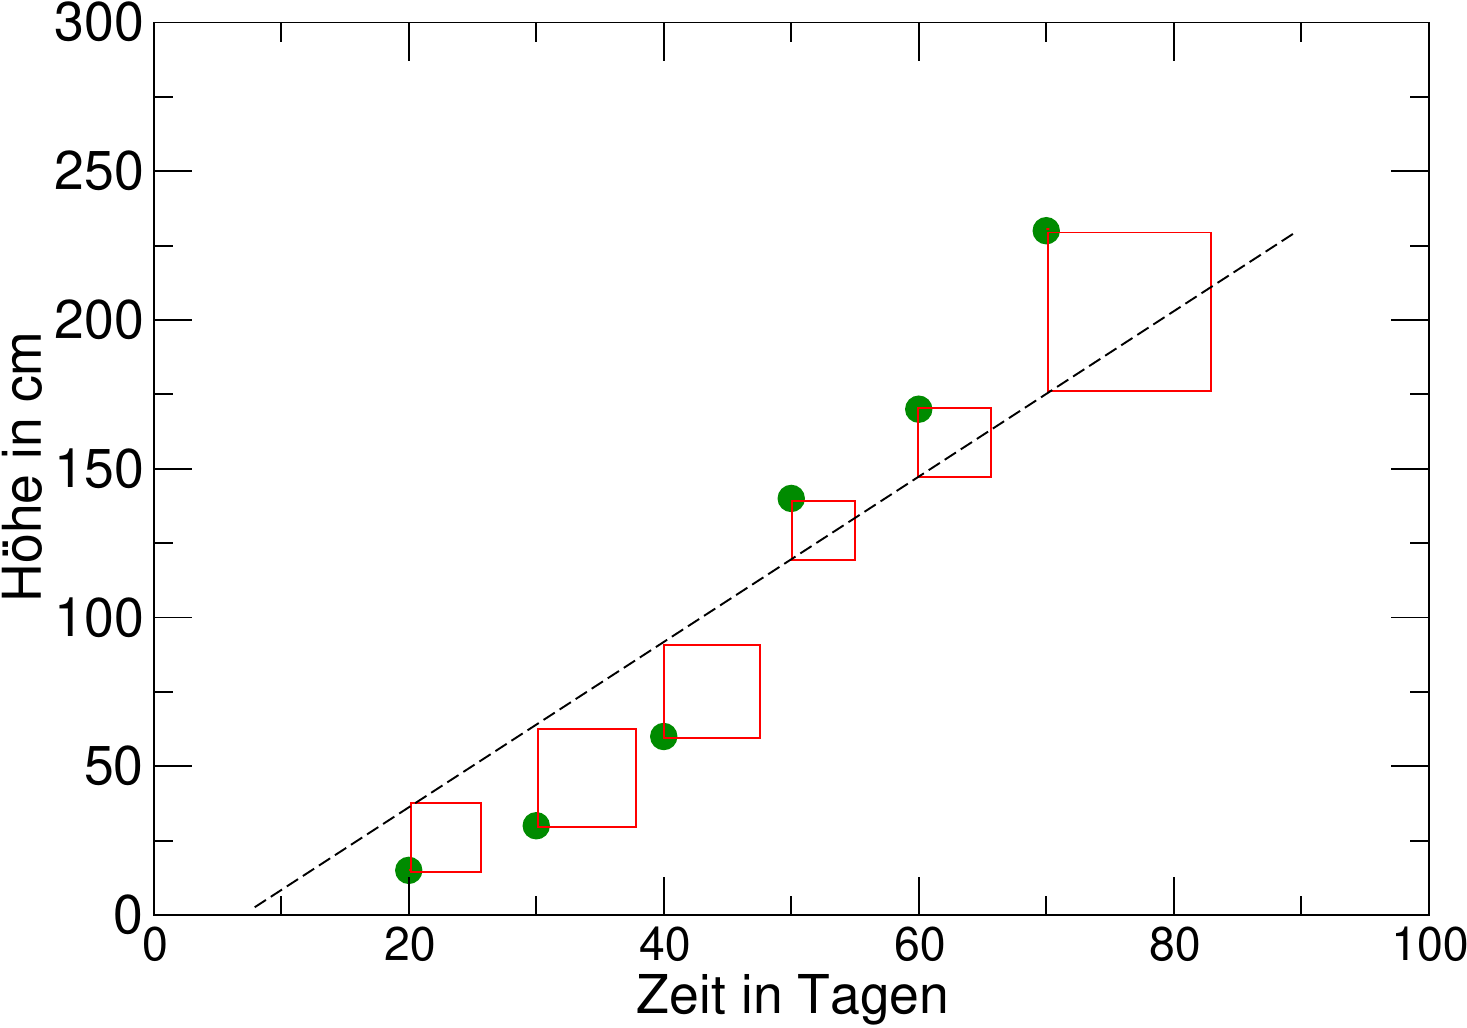
soll also minimal werden. Im Beispiel muss also
minimal werden.
Um das Minimum zu bestimmen, werden die partiellen Ableitungen von \(Q\) nach \(m\) und \(b\) bestimmt und gleich Null gesetzt:
Man erhält also zwei Gleichungen mit den zwei Unbekannten \(m\) und \(b\). Formal muss man natürlich zeigen, dass es sich tatsächlich um ein Minimum handelt!
Methode der kleinsten Quadrate (lineare Regression)
Es seien n Messwerte \(y_i, i=1\cdots n\) zu den Zeitpunkten \(t_i, i=1\cdots n\) gegeben.
Die Summe der Abstandsquadrate der Messwerte von der Geraden
\(y(t)=m\cdot t +b\) wird durch
mit den Mittelwerten \(\overline{t}=\frac{1}{n} \sum_{i=1}^n t_i\) und \(\overline{y}=\frac{1}{n} \sum_{i=1}^n y_i\) minimiert.
Mit den Größen Varianz und Kovarianz ausgedrückt gilt \(m = \frac{\displaystyle Cov(t,y)}{\displaystyle V(t)}\)
mit \(V(t)=\frac{1}{n} \sum_{i=1}^n( t_i -\overline{t})^2\) und \(Cov(t,y)=\frac{1}{n} \sum_{i=1}^n( t_i -\overline{t})\cdot (y_i -\overline{y})\).
Im Beispiel erhält man die Gerade
Das so bestimmte Wachstum beträgt also 4.44 cm pro Tag. In Abbildung 2.6 sieht man, dass die Gerade zwar keinen der Messpunkte genau trifft, aber trotzdem besser ist als die Gerade in Abbildung 2.3. Dies liegt daran, dass Ausreißer weniger stark einfließen.
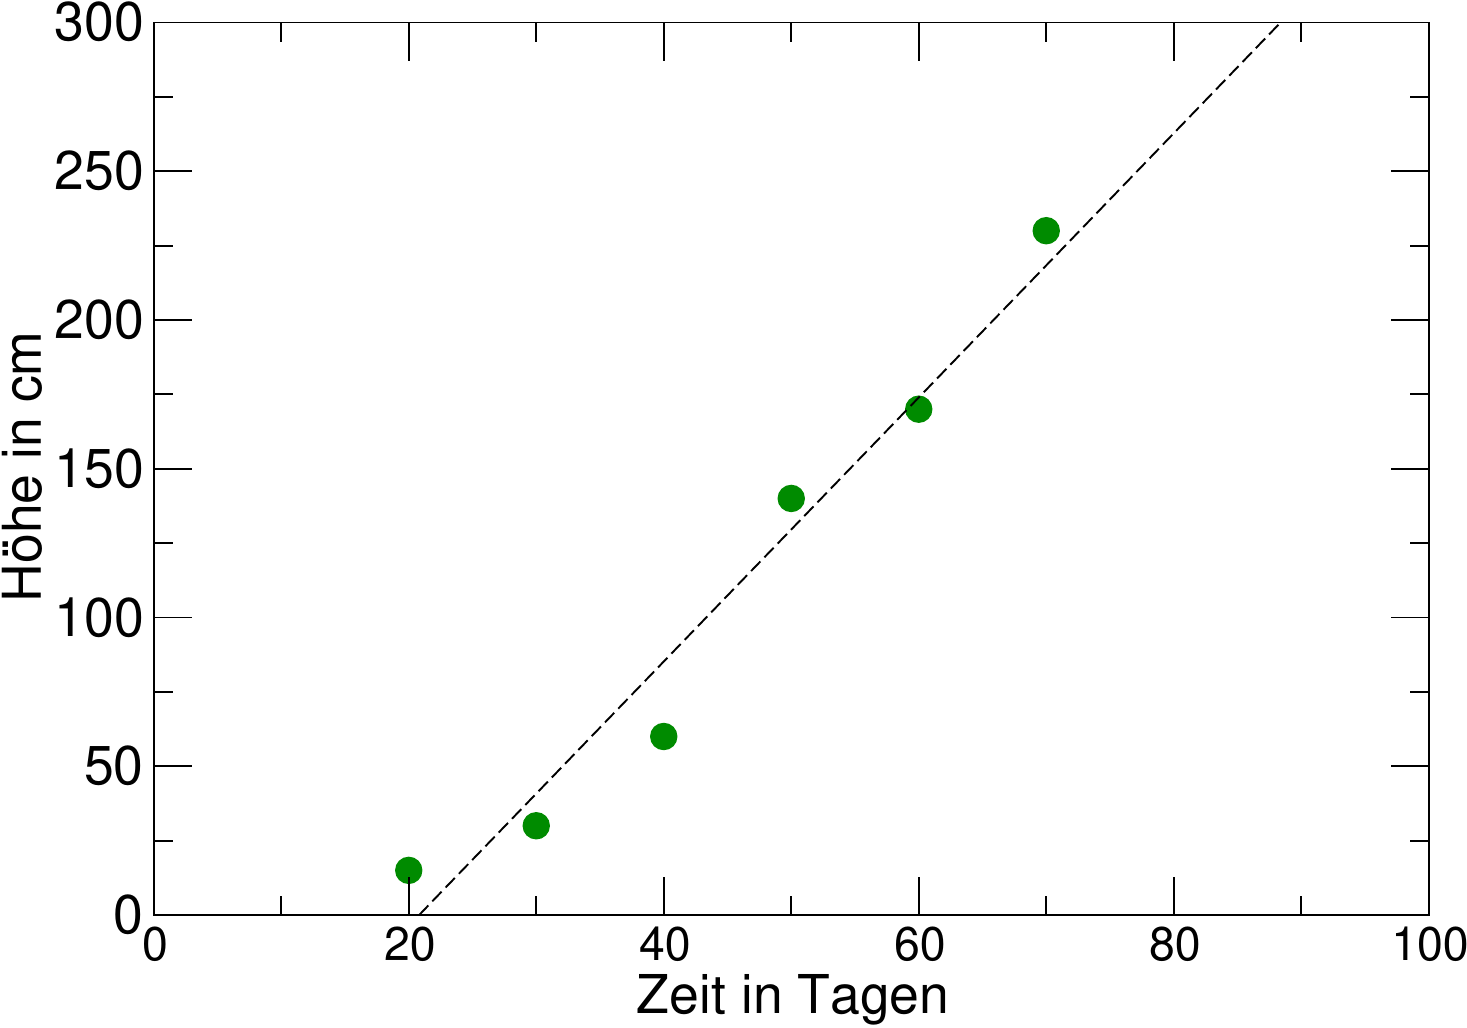
Das Verfahren der linearen Regression ist in vielen wissenschaftlichen Taschenrechnern und Tabellenkalkulationsprogrammen implementiert. Diese geben meistens zusätzlich zu den Parametern das sogenannte Bestimmtheitsmaß \(r^2\) an. Hierbei ist \(r\) durch
gegeben. Das Bestimmtheitsmaß \(r^2\) gibt den Anteil der durch die unabhängige Größe \(t\) erklärten Varianz an der Gesamtvarianz von \(y\) an. Liegen die Werte exakt auf einer Geraden, so ist \(r^2=1\).
2.3 Logarithmischer Zusammenhang
Häufig folgen natürliche Prozesse keinem linearen Zusammenhang. Am folgenden Beispiel soll gezeigt werden, wie die Methode der linearen Regression auf Prozesse angewendet werden kann, die einem logarithmischen Zusammenhang folgen.
Beispiel: Karzinogenese bei Ratten
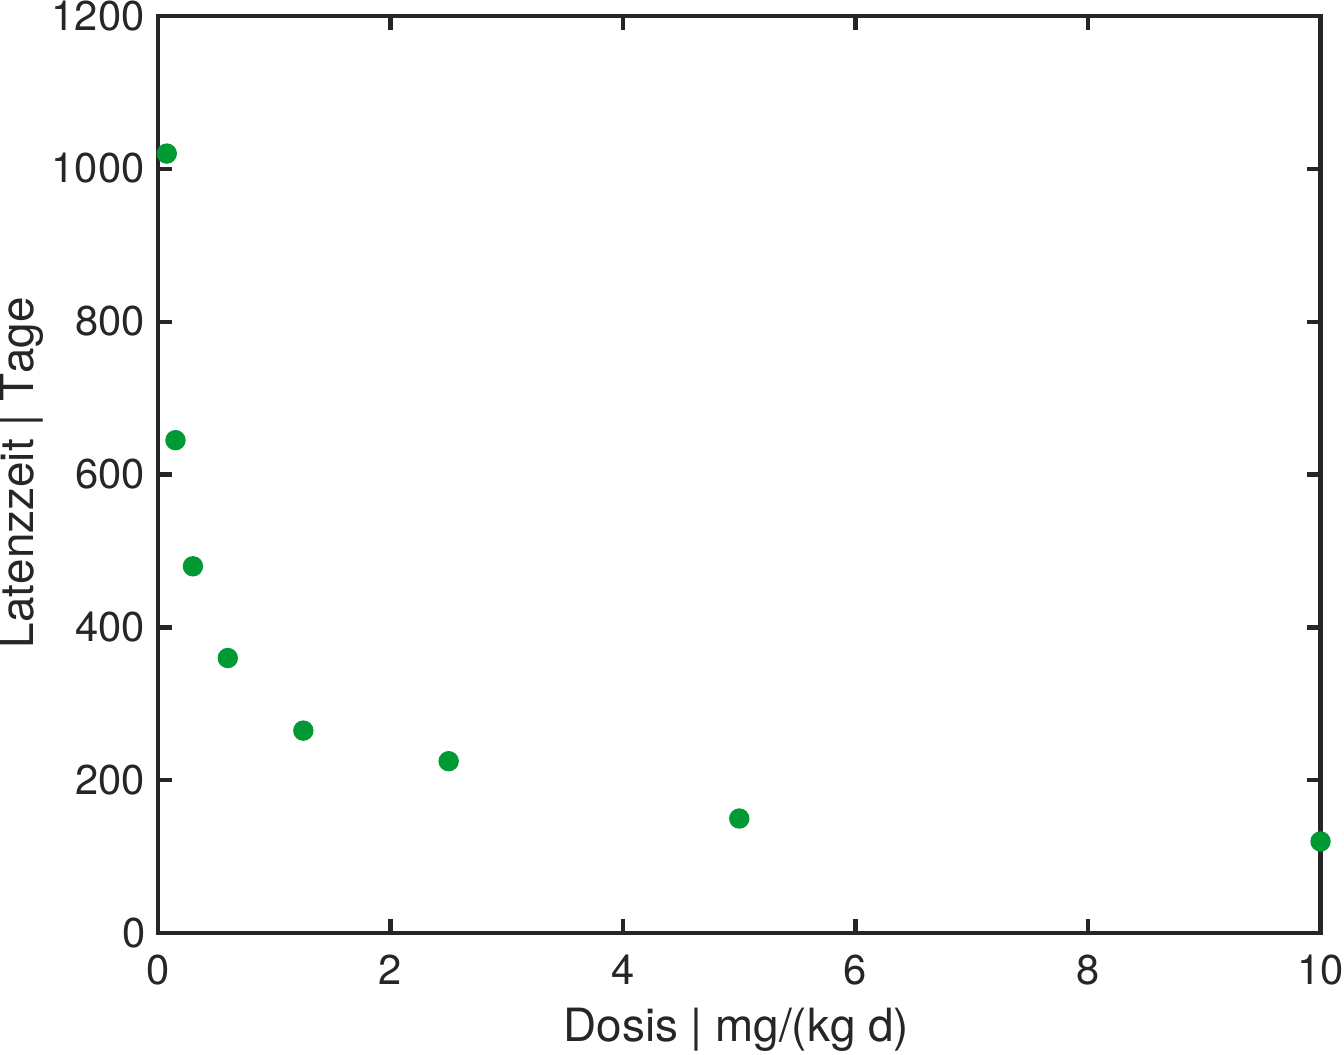
Durch Gabe von Diethylnitrosamin, kann bei Ratten Krebs ausgelöst werden. Je höher die tägliche Dosis ist, desto schneller entwickeln die Ratten einen Tumor. Die Zeit von der Diethylnitrosamingabe bis zur Ausbildung des Tumors heißt Latenzzeit. Es besteht folgender Zusammenhang
Auf den ersten Blick kann man nicht entscheiden, welcher Zusammenhang besteht (Abbildung 2.7).
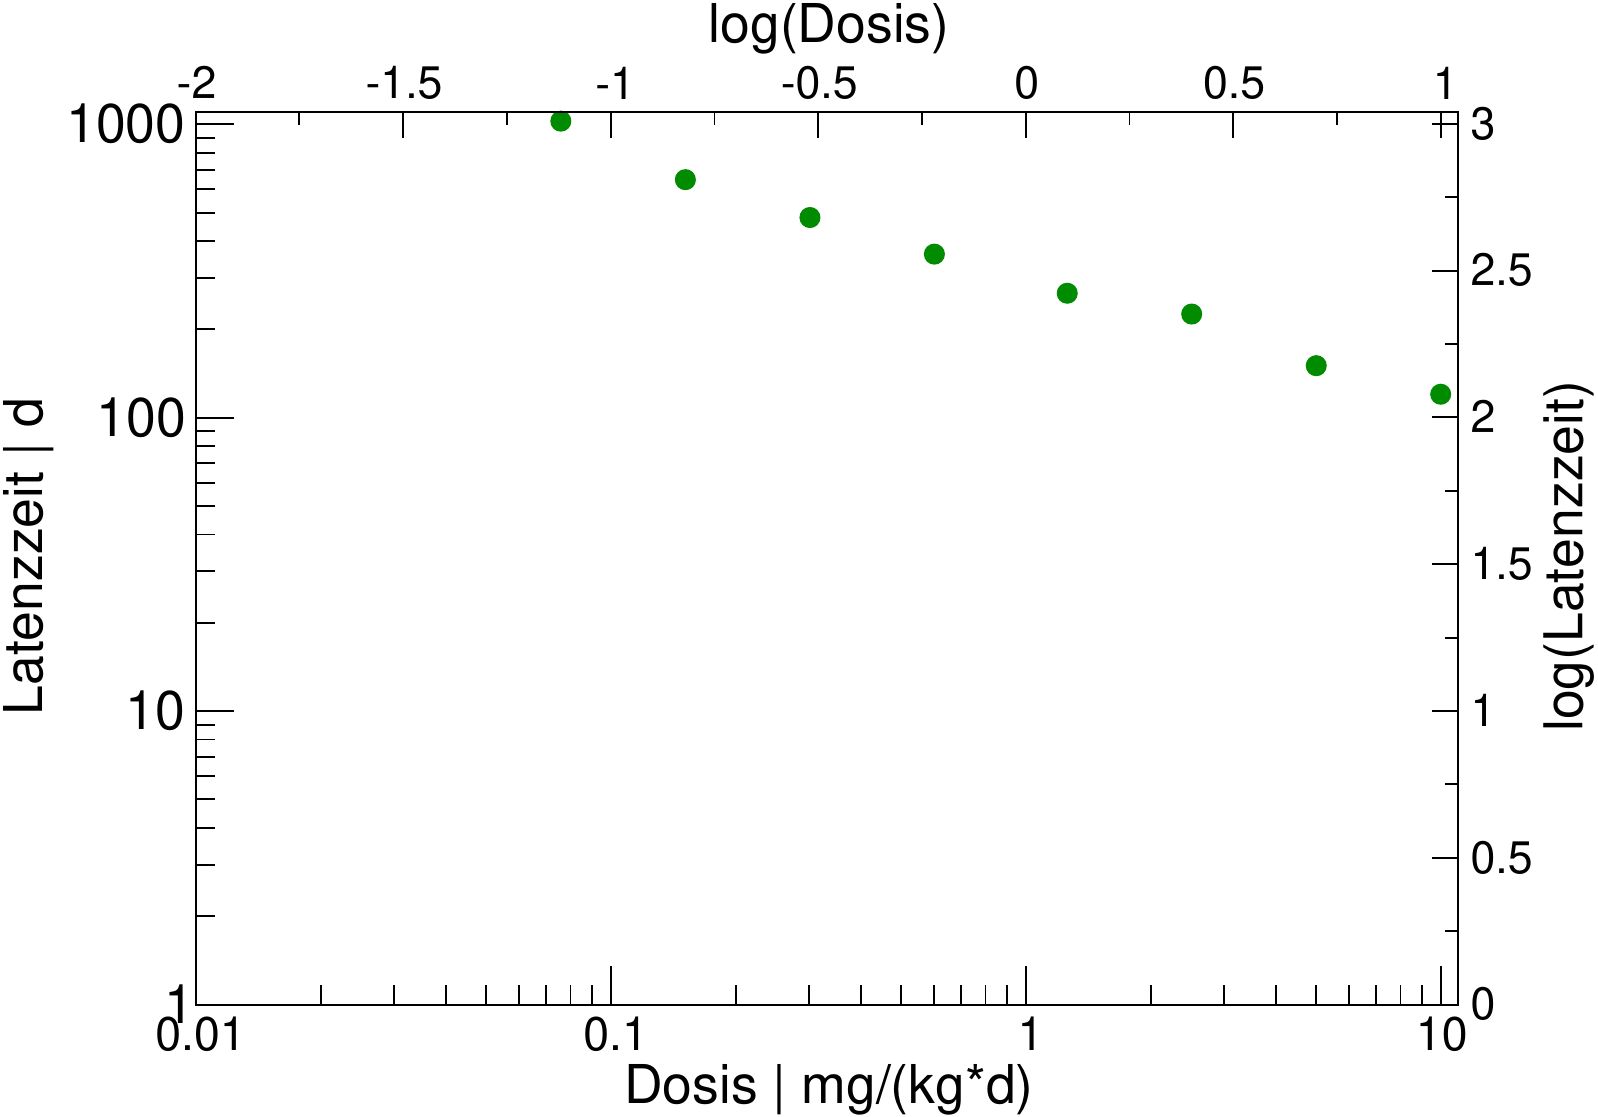
Trägt man die Datenpunkte doppelt logarithmisch auf so erkennt man den Zusammenhang (Abbildung 2.8). Doppelt logarithmisch bedeutet, dass sowohl die x- als auch die y-Achse logarithmisch sind. Hierbei ist es unerheblich, ob man die Achsenskalierungen logarithmisch wählt oder die Werte in der Tabelle logarithmiert und die Achsen linear skaliert (siehe Achsen in Abbildung 2.8). Es scheint ein linearer Zusammenhang zwischen dem Logarithmus der Dosis und dem Logarithmus der Latenzzeit zu bestehen:
Die Parameter \(m\) und \(b\) kann man nun mit der Methode der kleinsten Quadrate bestimmen. Hierzu macht man sich zuerst die Wertetabelle der logarithmierten Werte. Man beachte, dass diese Werte keine Einheit haben!!:
Man erhält \(m=-0.42\) und \(b=2.48\).
Aus \(log(Latenzzeit) = m\cdot log(Dosis) + b\) folgt
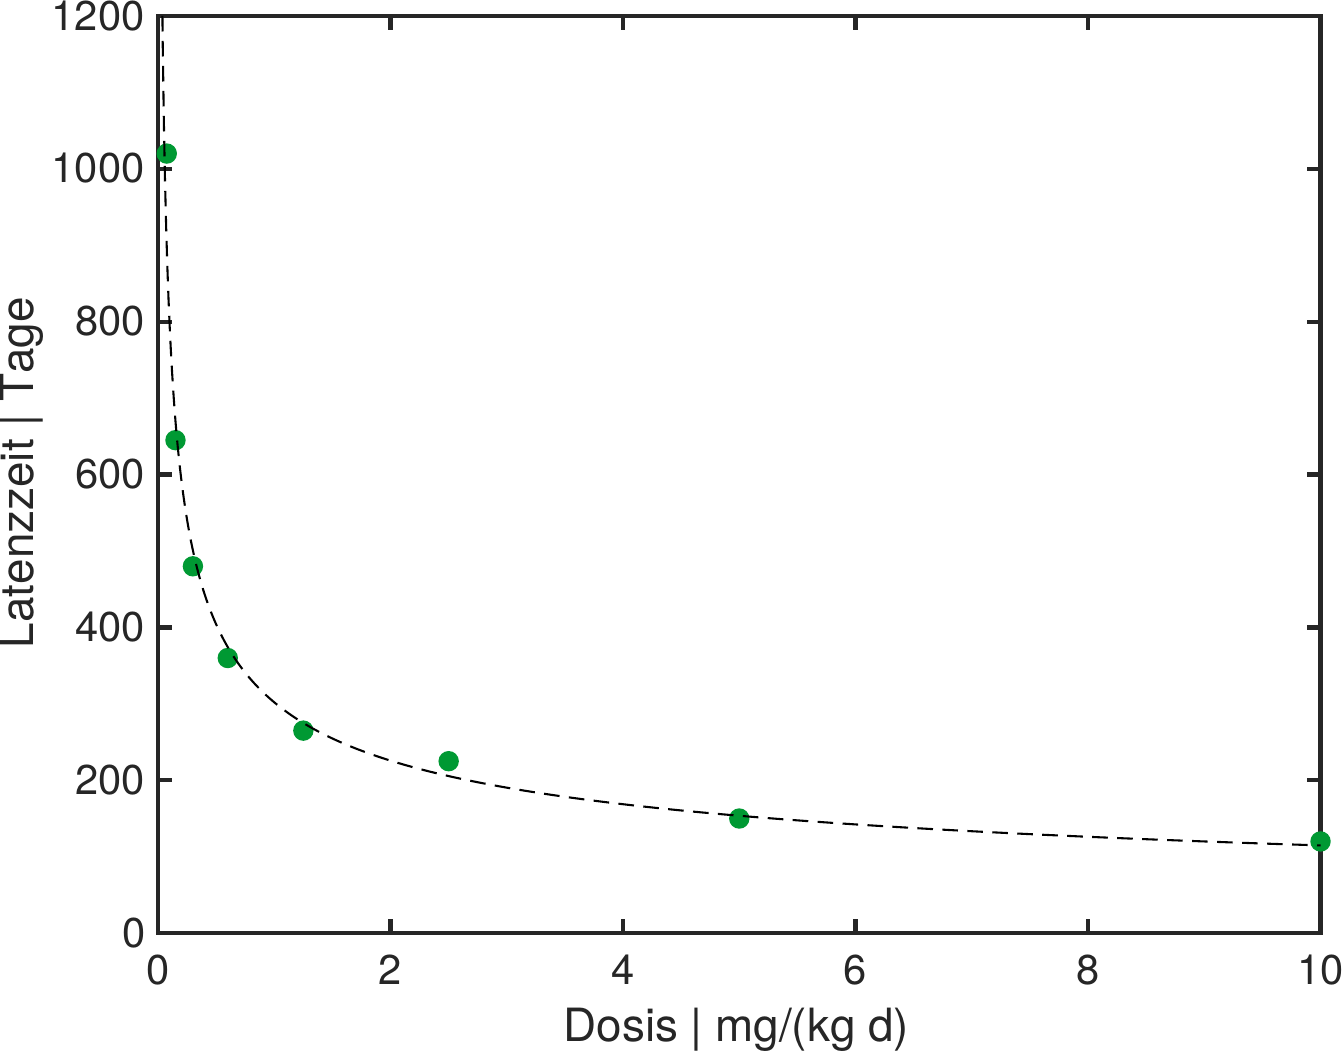
Im Beispiel gilt also
Dieser funktionale Zusammenhang ist in Abbildung 2.9 dargestellt. Man hat nun eine Funktion, mit der man zu einer gegebenen Dosis die Latenzzeit bestimmen kann. In der Praxis wird die tatsächliche Latenzzeit davon abweichen (Ratten sind keine Computer). Auch weiß man nicht, welchen Gültigkeitsbereich das Gesetz hat (bei sehr hohen Dosen werden die Ratten vermutlich viel schneller Tumore entwickeln, bei sehr niedrigen eventuell gar keine).
2.4 Verallgemeinerung der linearen Regression
Weiß man, dass der Zusammenhang zwischen abhängiger und unabhängiger Variablen einem anderen Gesetz folgt, so kann man auch hierauf optimieren. Viele Softwarepakete und Taschenrechner haben hierzu eine Reihe von Funktionen implementiert:
Bei der Optimierung mit Hilfe der angegebenen Funktionen handelt es sich auch um lineare Regressionen, da die Parameter \(\beta_i\) nicht in höherer Potenz vorkommen. Allgemein handelt es sich um eine lineare Überlagerung von einfachen Funktionen:
Die Parameter \(\beta_j\) heißen Regressionskoeffizienten und es gilt \(h_j(x)=x^j\).
Die Lösung eines Optimierungsproblems läuft analog wie im Falle der Geraden. Man leitet die Funktion der Summe der Abstandquadrate nach den Parametern ab, setzt diese gleich Null und erhält \(J\) Gleichungen mit \(J\) Unbekannten.
2.4.1 Fourieranalyse
Nun ist es nicht zwingend, dass die Funktionen \(h_j\) Potenzen von \(x\) sind. Hat man Messwerte, von denen man weiss, dass sie einer Periodizität unterliegen, wie z.B. der Temperaturverlauf eines Jahres, so kann man auch periodische Funktionen als Basis wählen. Das bekannteste Beispiel hierfür ist die Fourier-Analyse. Man wählt als Funktion eine Überlagerung aus Sinus- und Kosinusfunktionen:
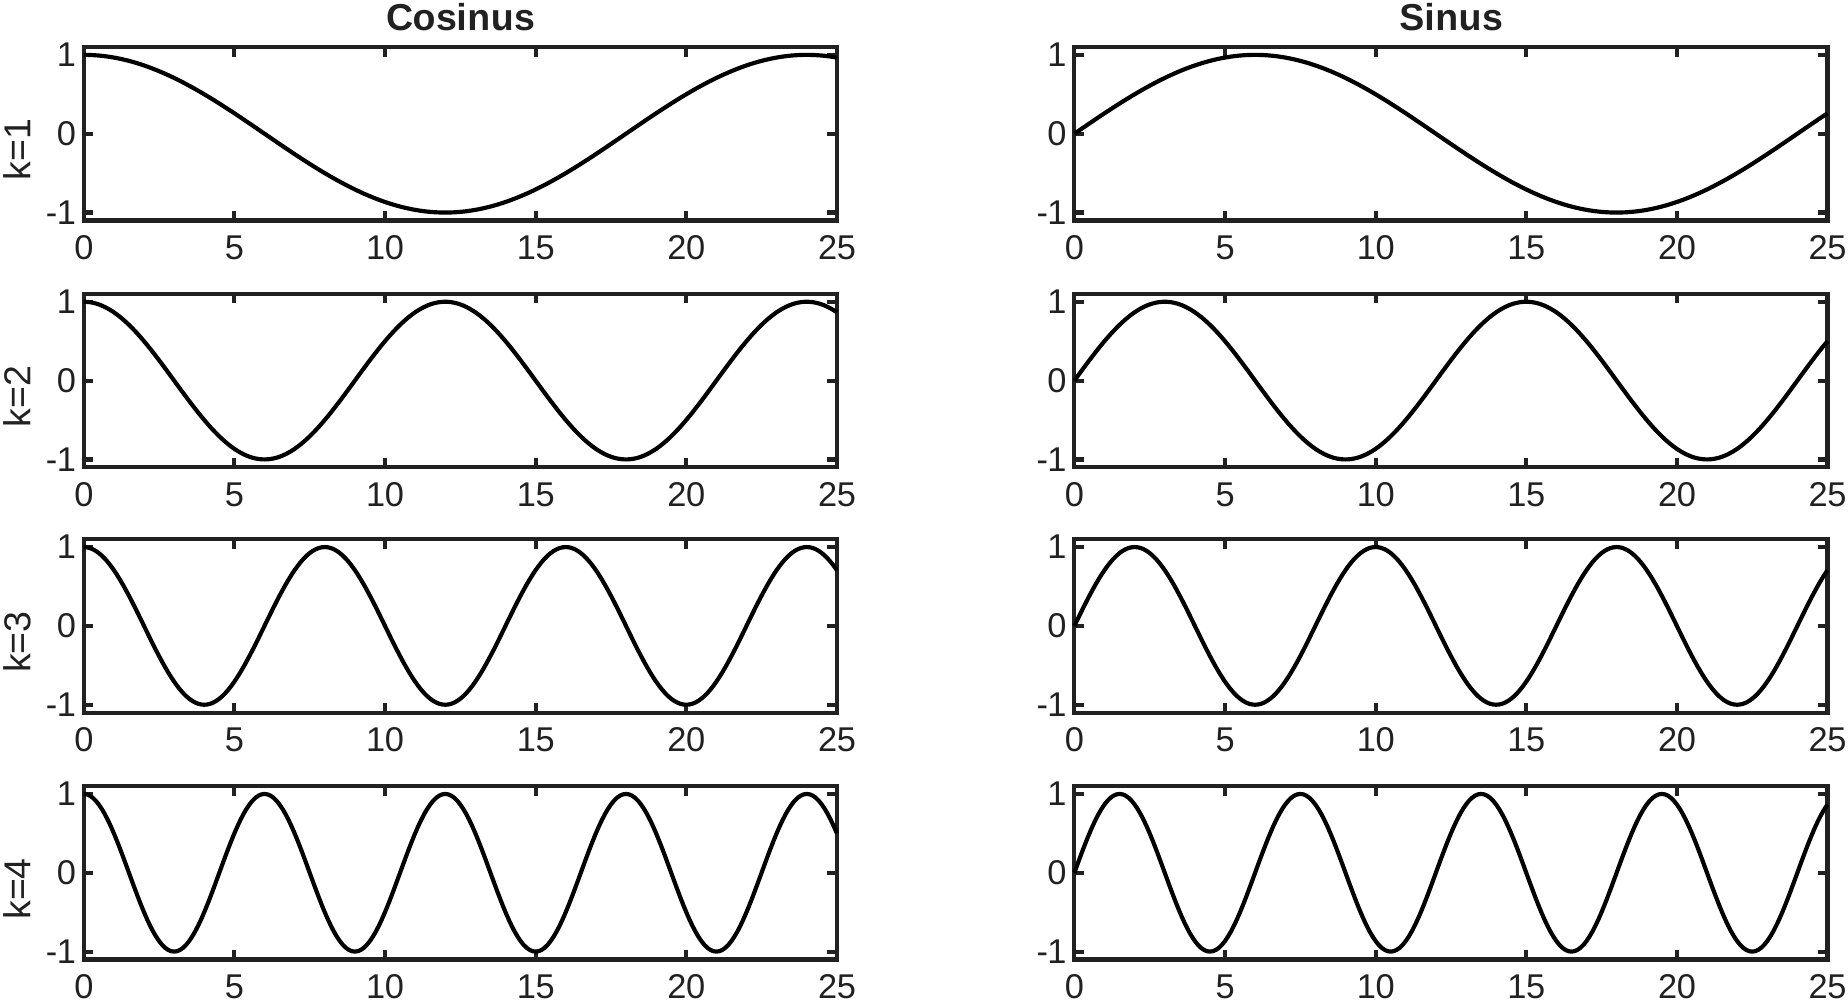
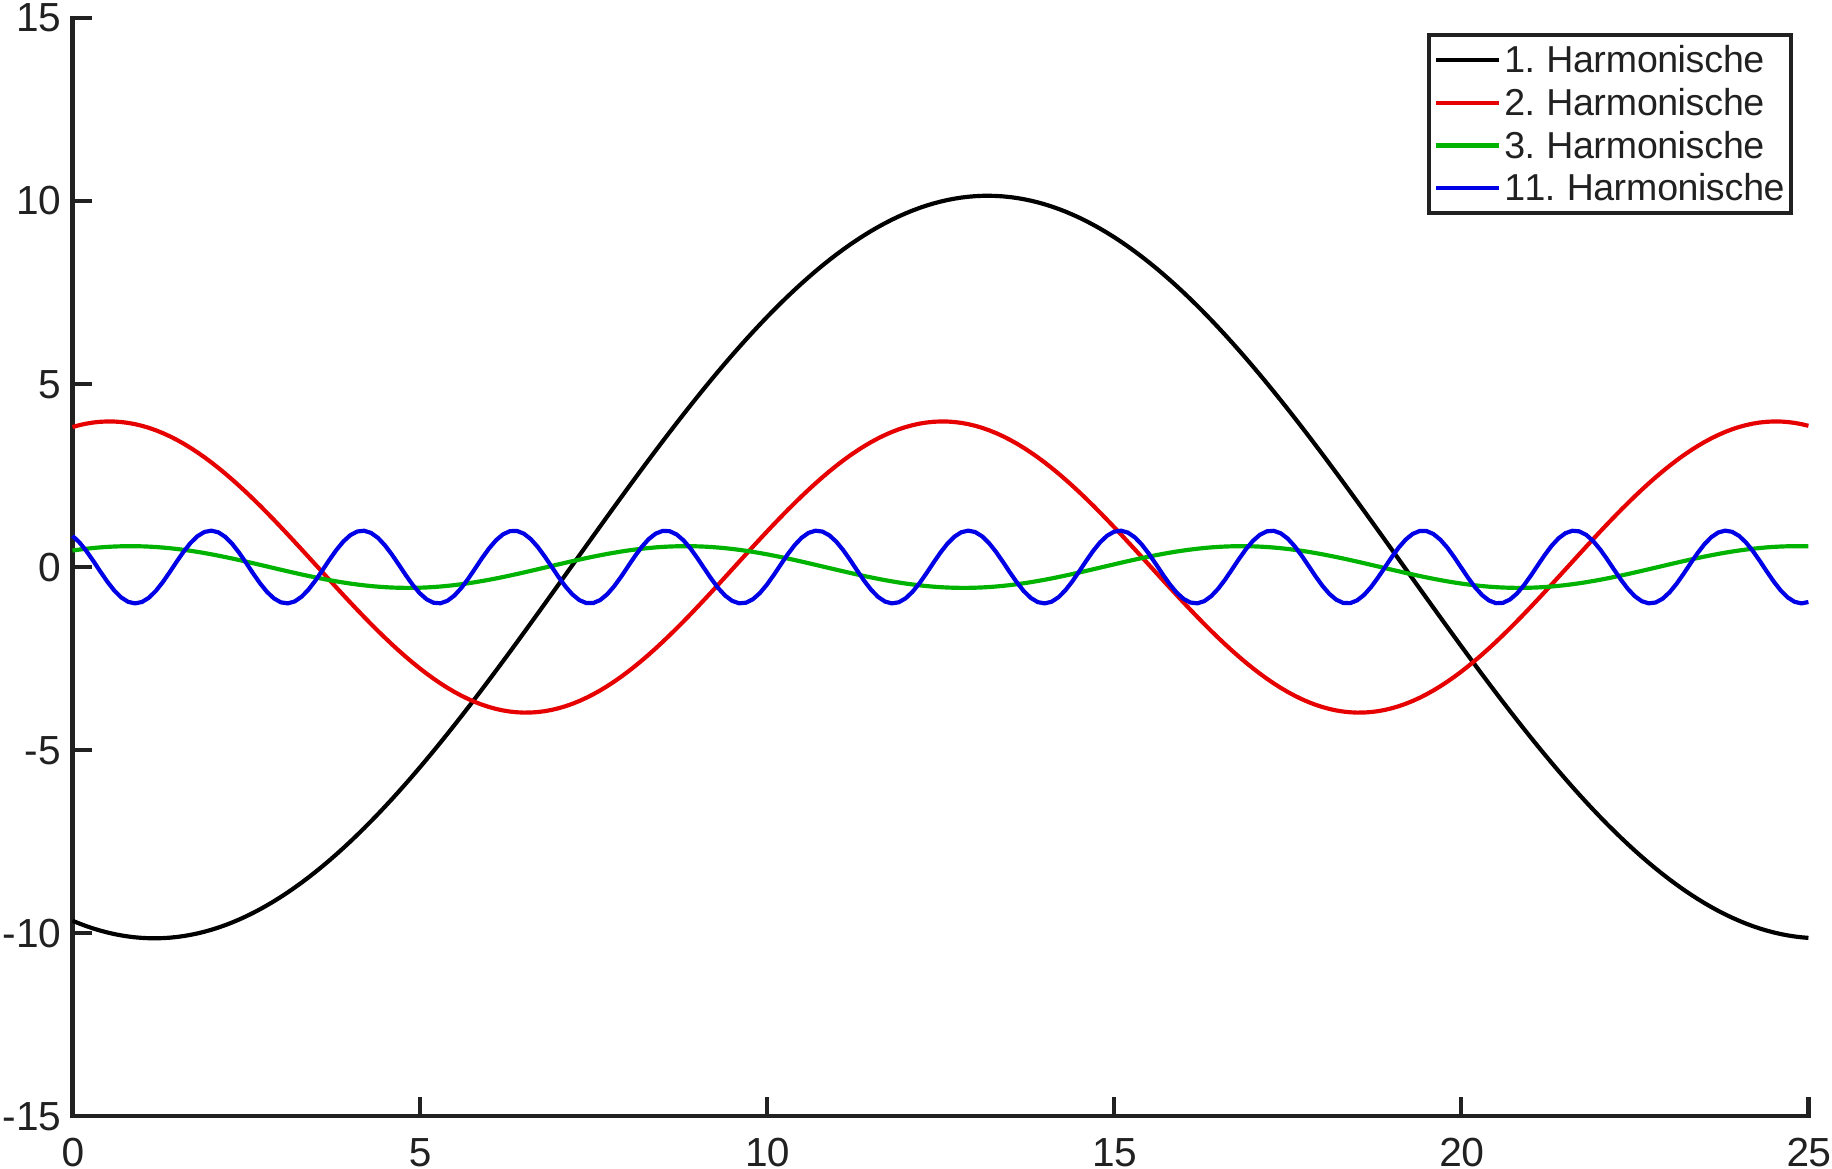
wobei die Funktionen hier von der Zeit t abhängen und \(T\) die Periodenlänge ist. Der Index k gibt die Ordnungszahl der Harmonischen das Vielfache der Grundfrequenz \(\frac{2\pi}{T}\) an. Diese basisfunktionen sind in Abbildung 2.10 dargestellt.
Die Funktion wird nun wie folgt rekonstruiert:
Der erste Term \(a_0\) beschreibt den Mittelwert oder auch Gleichanteil, der Laufindex \(k\) ist die Ordnungszahl der Harmonischen, dem Vielfachen der Grundfrequenz \(\frac{2\pi}{T}\). Die Grundfrequenz (\(k=1\)) ergibt die sogenannte erste Harmonische, für \(k=2\) erhält man die 2. Harmonische oder auch erste Oberwelle, usw. Sind die Stützwerte \(t_i\) der Messwerte \(y_i\), \(i=1, \dots, N\) äquidistant über die Periode T verteilt, so ergibt sich für die optimalen Parameter
Gleichung 2.1 nennt man Fouriersumme (für \(J\rightarrow \infty\) Fourierreihe). Die Koeffizienten \(a_k\), \(b_k\) (2.2) heißen Fourierkoeffizienten. Sie sind hier die Regressionskoeffizienten. Die Zahl der zu bestimmenden Koeffizienten ist \(2J+1\), daher muss die Zahl der äquidistanten Messwerte N mindestens dieser Anzahl entsprechen:
Diese Beziehung findet man unter dem Begriff Abtasttheorem. Andersherum ausgedrückt, wenn man N äquidistante Abtastwerte hat, kann man das Signal maximal bis zur Harmonischen \(J\) rekonstruieren.
Für die Fourieranalyse gibt es viele verschiedene Darstellungsweisen. So kann man als Basisfunktionen nur Kosinusfunktionen nehmen oder auch komplexe Exponentialfunktionen. Daher ist es schwierig, sich in der Literatur zurechtzufinden, da alle Notationen sehr ähnlich aussehen. Glücklicherweise muss man dies alles nicht selber programmieren. Für viele Programmpakete, wie z.B. MatLab oder R gibt es getestete Implementierungen der Fourieranalyse.
Beispiel: Temperatur an einem Septembertag
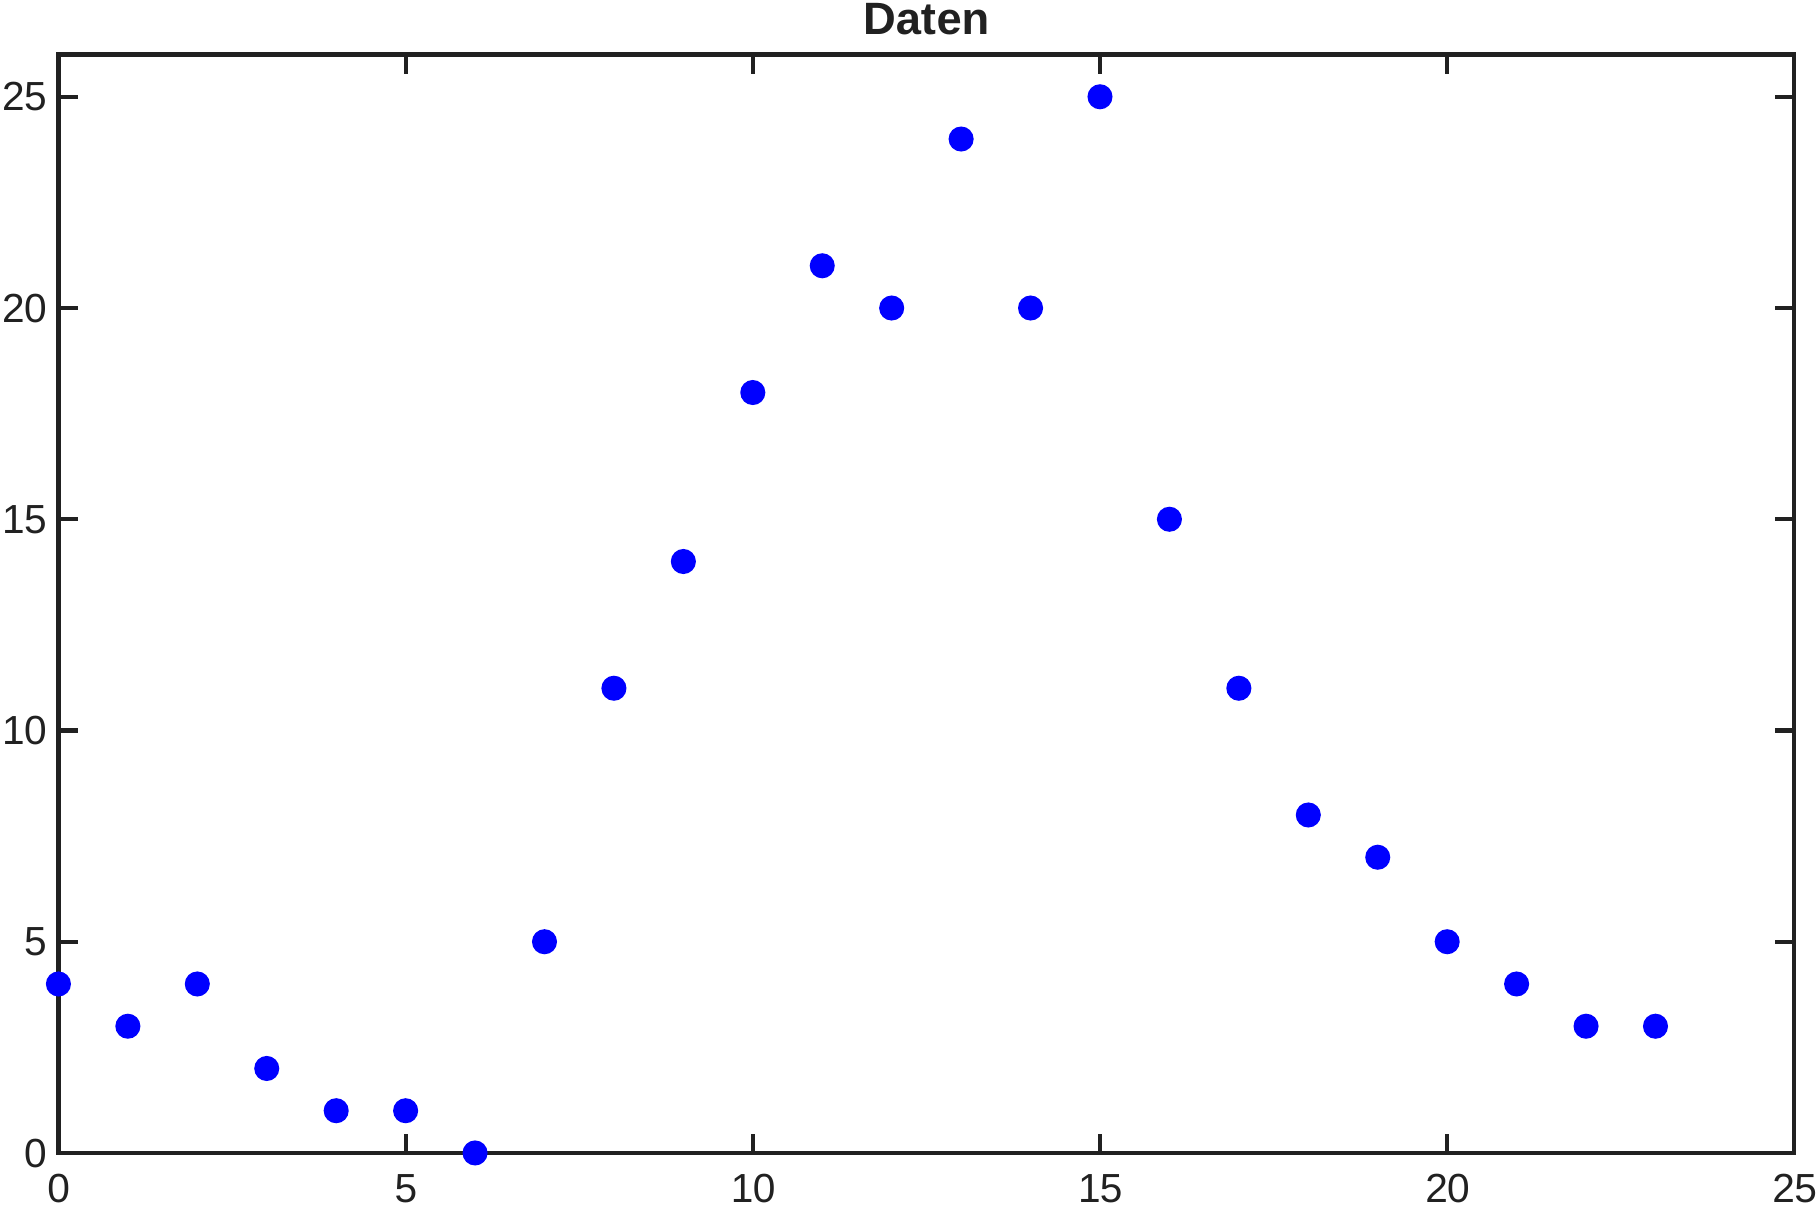
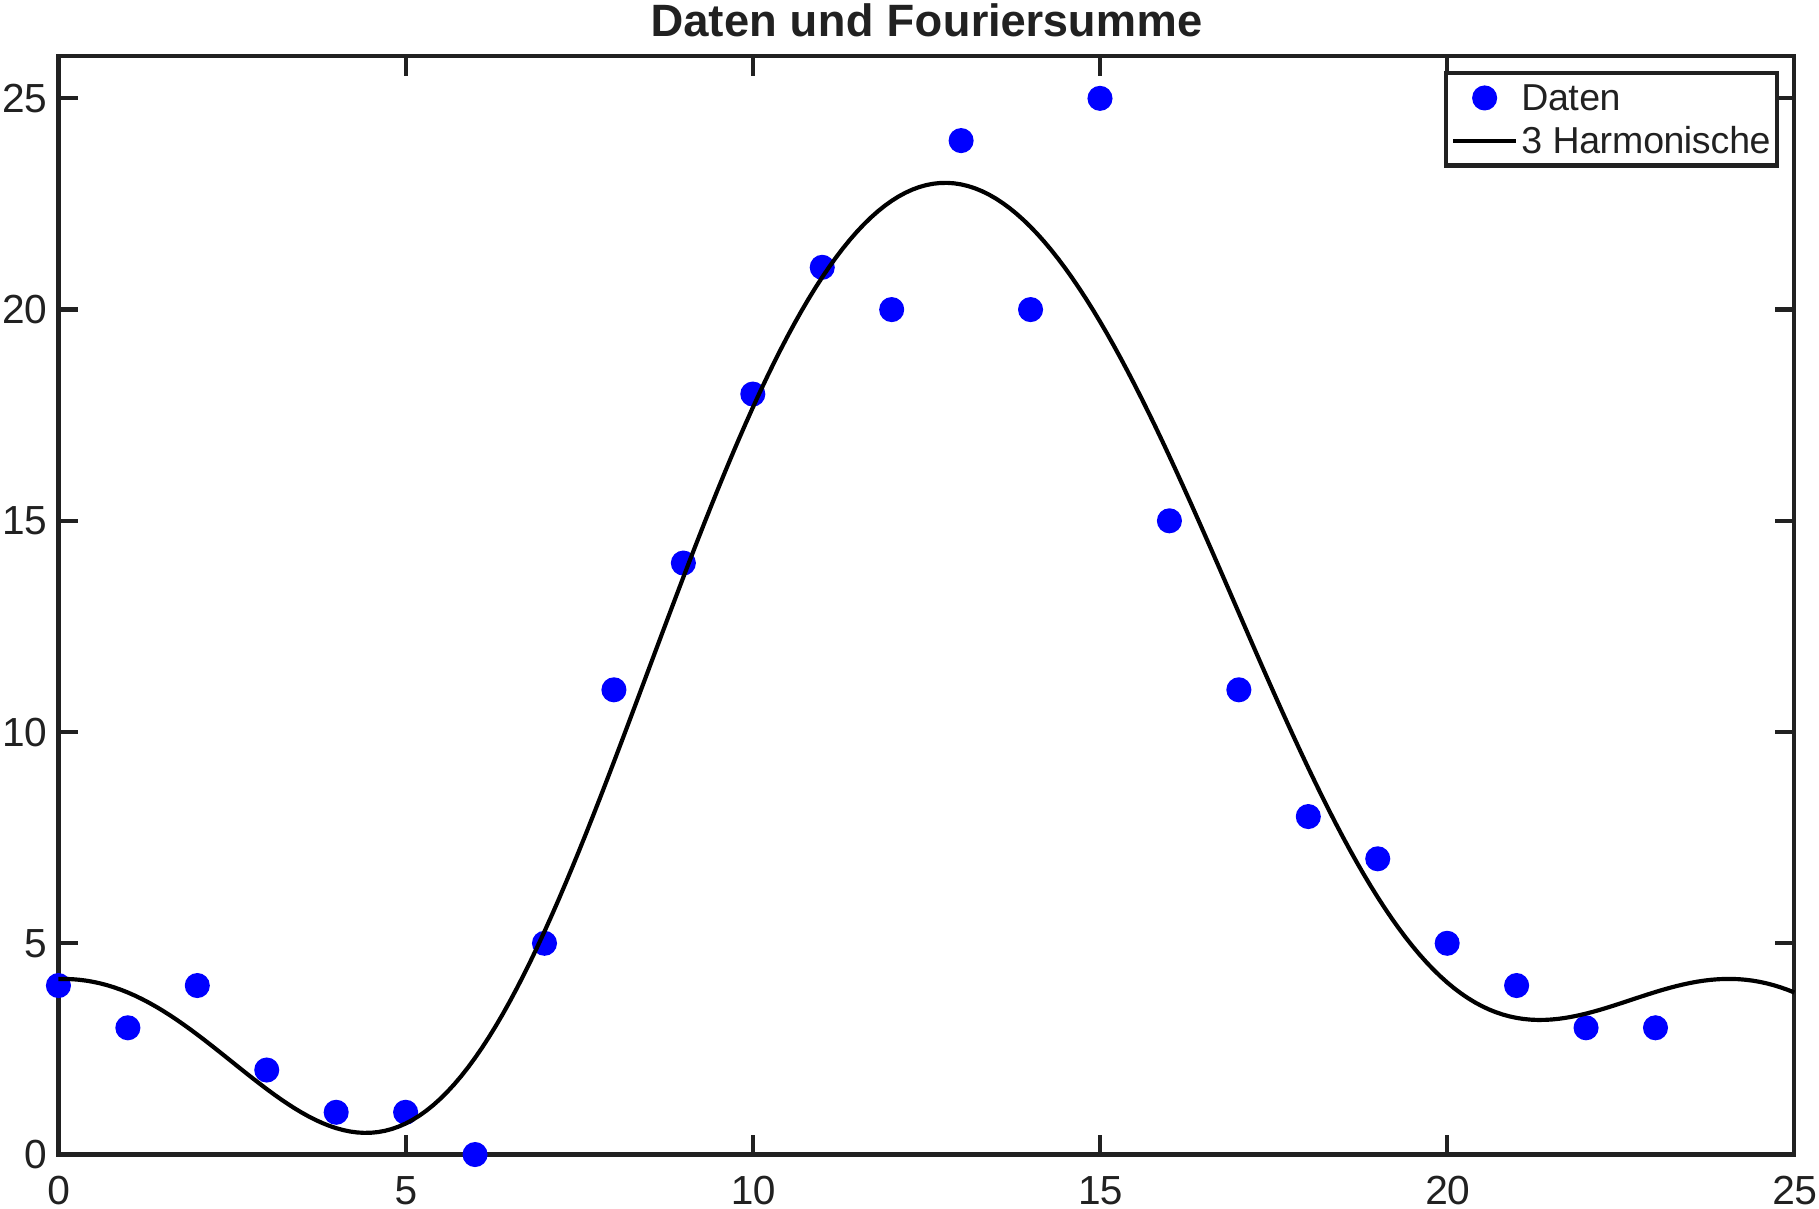
In diesem Beispiel liegen nun stündliche Temperaturdaten eines Septembertages vor (Abbildung 2.11). Diese sollen nun mit Hilfe der Fourieranalyse und anschließender Synthese durch eine Überlagerung von Sinus und Kosinusfunktionen beschrieben werden. Die Anzahl der Messwerte is N=24. damit ergibt sich für die Anzahl der Harmonische J=11 (\(N\ge 2J+1\)). Das Ergebnis ist in Abbildung 2.12 (rechts) zu sehen. Die einzelnen Messdaten werden von der Funktion getroffen.
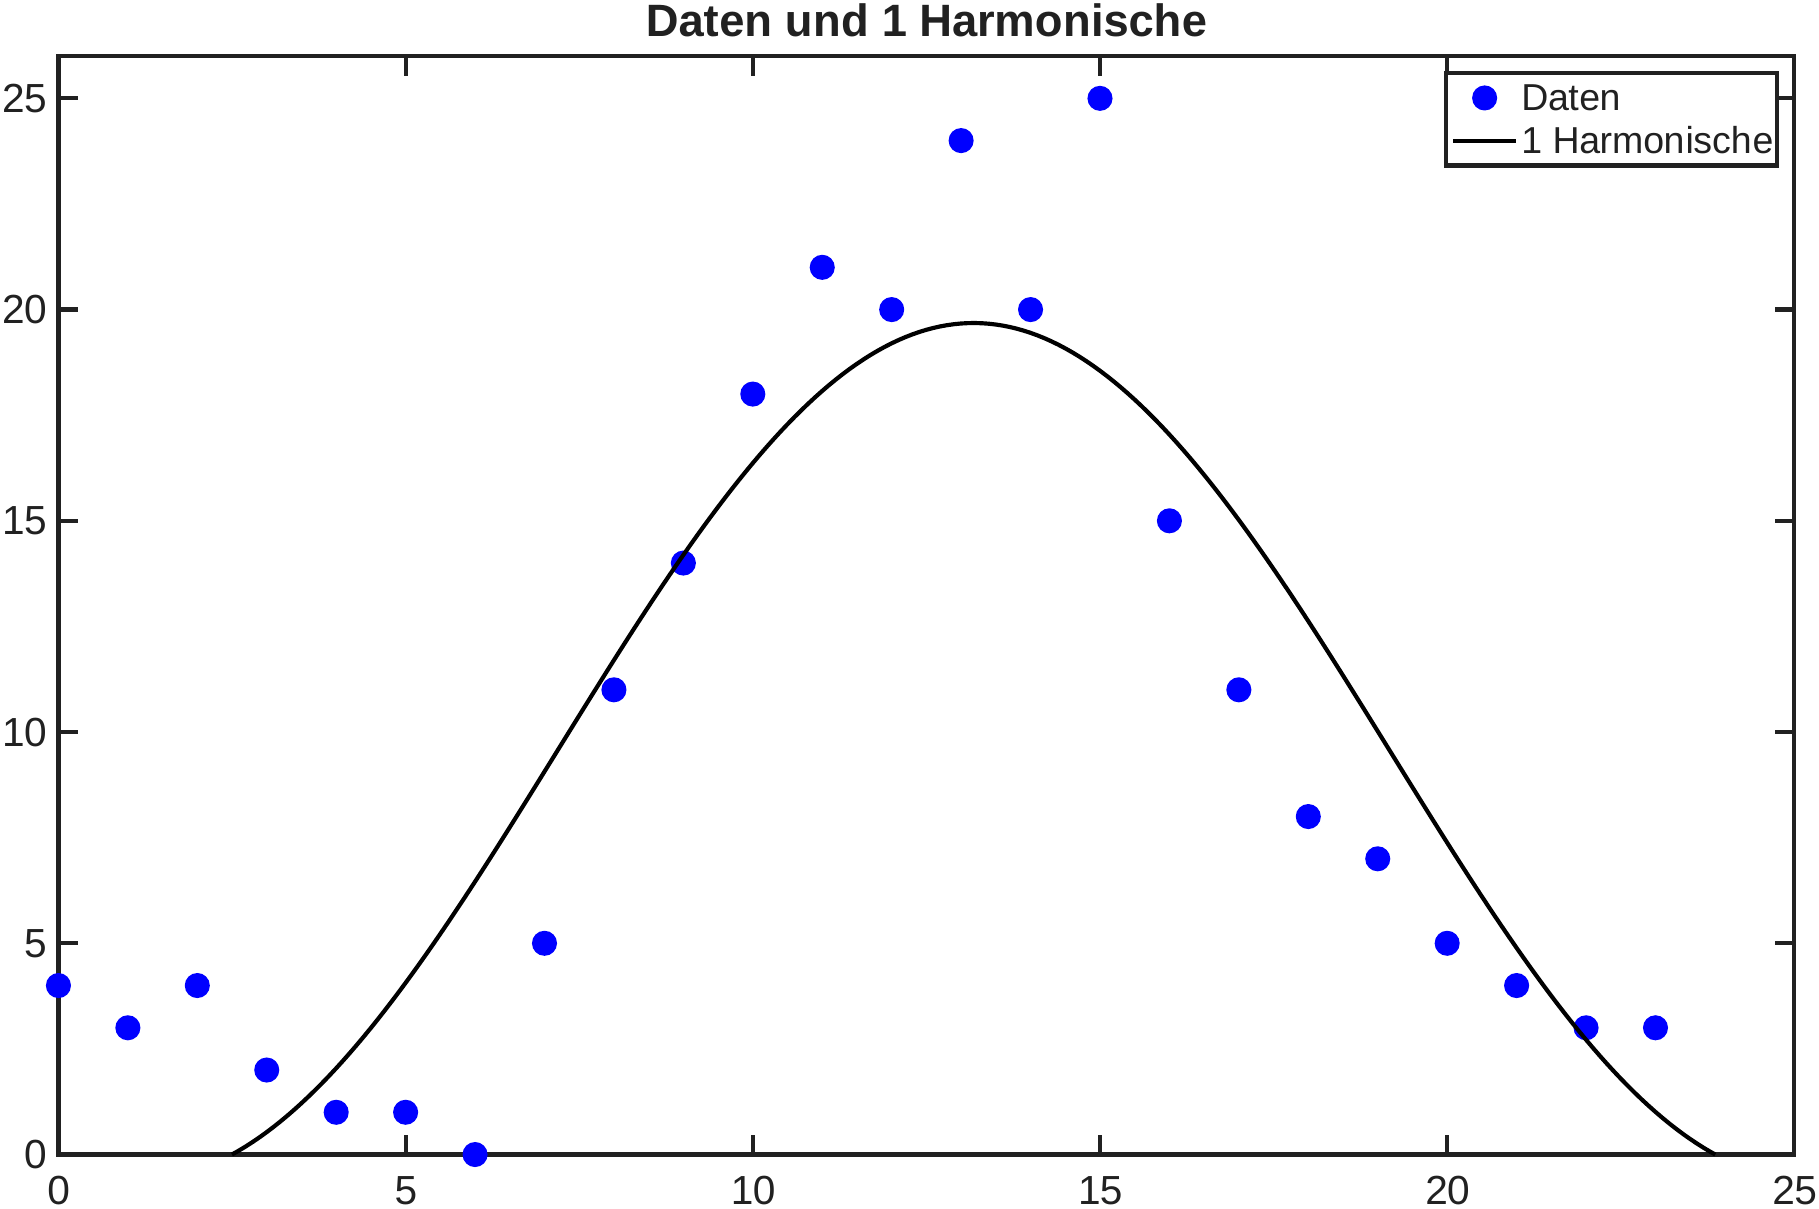
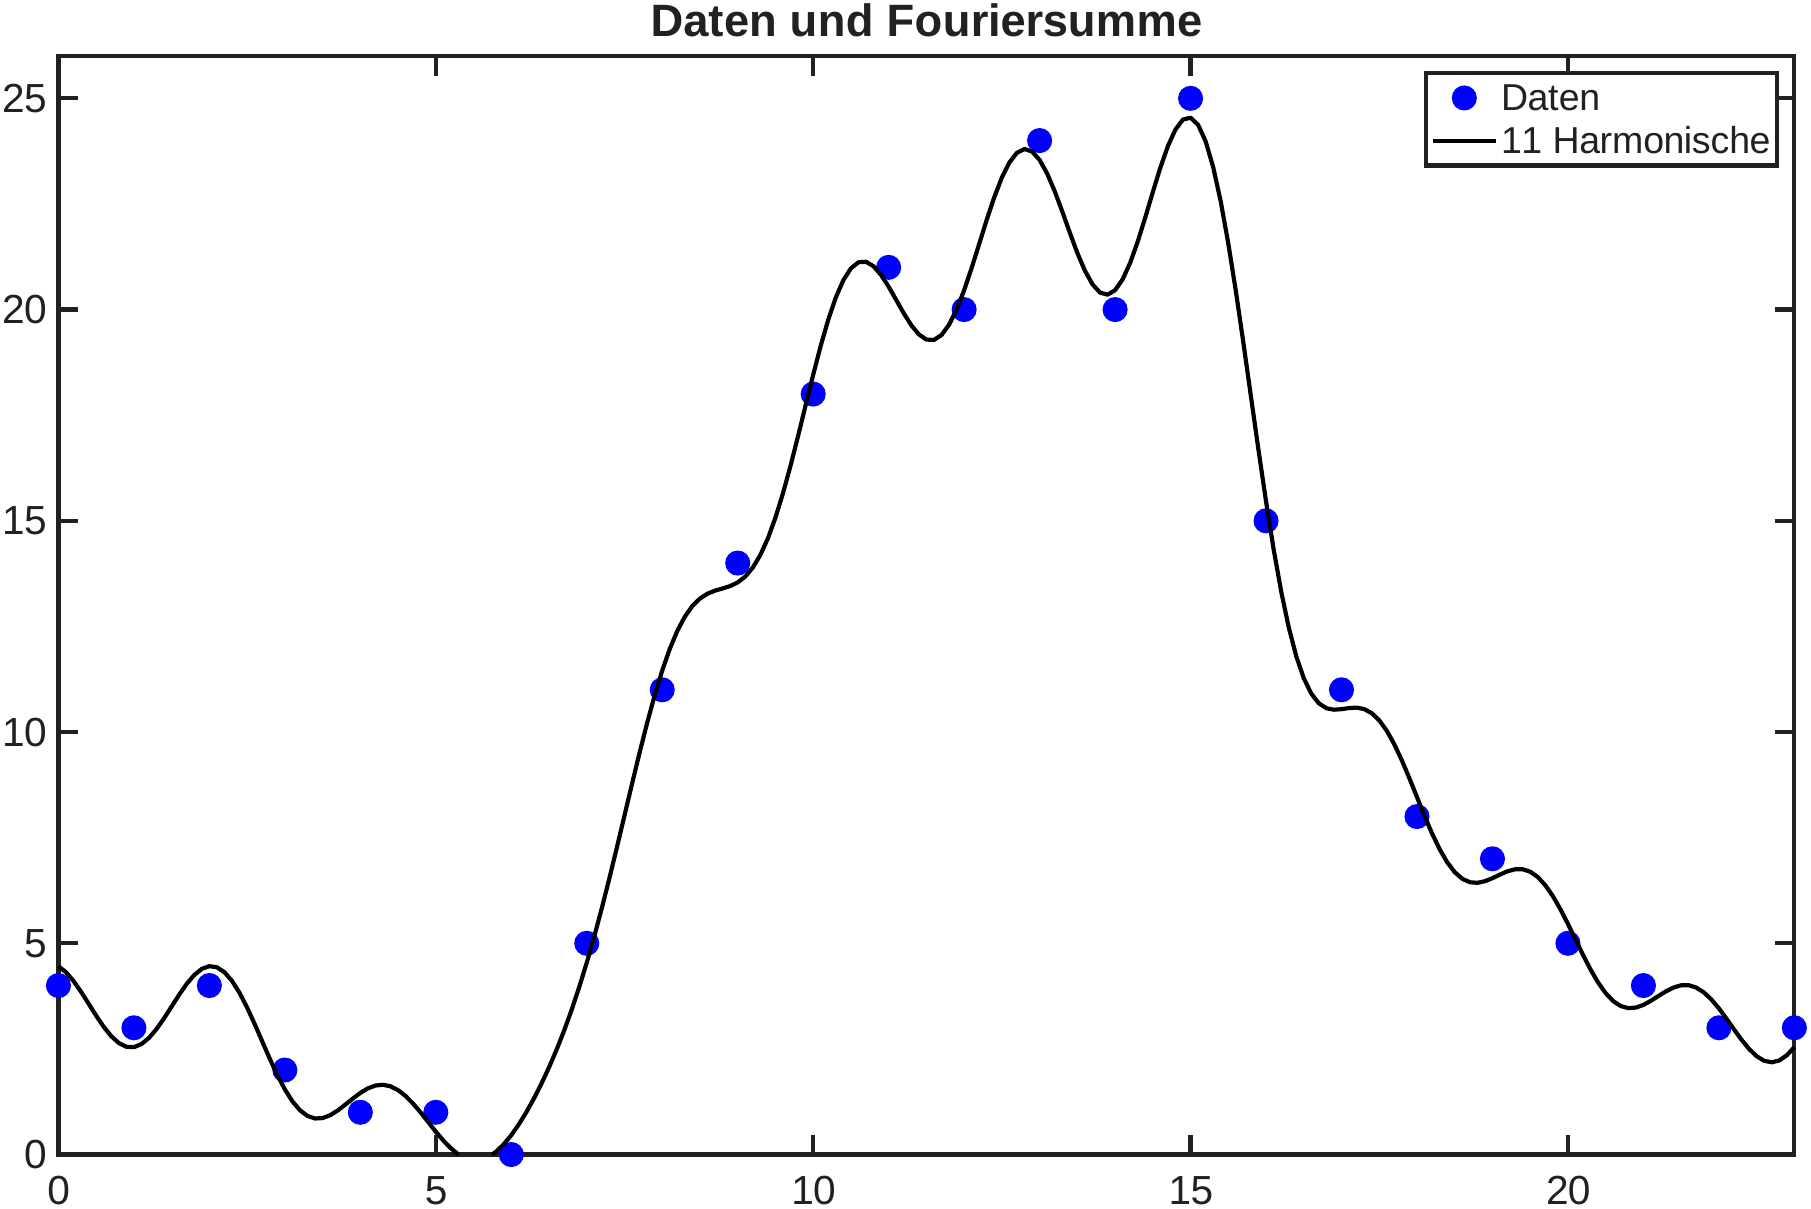
In Abbildung 2.12 (links) sieht man die Approximation durch die Grundwelle (1. Harmonische).Die zugehörige Funktion bis zur 1. Harmonischen lautet entsprechend Gleichung (2.1)
mit den Parametern \(a_0 = 9.46\), \(a_1 = -9.54\), \(b_1 =-2.96\) (gerundet). Die letzte Zeile ergibt sich aus den Additionstheoremen für trigonometrische Funktionen, wobei \(A=\sqrt{a_1^2+b_1^2}\) und \(\tan \varphi= -\frac{b_1}{a_1}\) gilt.2 Damit handelt es sich bei der 1. Harmonischen um eine phasenverschobene Kosinusfunktion. Dies entspricht in etwa dem Ergebnis zu den Nordseedaten, das in Abschnitt 2.1 beschrieben wurde. Nur dass hier aufgrund der Konstruktion über die Methode der kleinsten Quadrate die beste Anpassung gefunden wird. Man kann so auch die gesamte Fouriersumme (Gleichung 2.1) nur mit Kosinusfunktionen darstellen. Man hat dann als Parameter die Amplituden \(A_k\) und die Phasenwinkel \(\varphi_k\). Diese Darstellung nennt man auch spektrale Darstellung. In Abbildung 2.13 sind exemplarisch ein paar Harmonische einzeln dargestellt. Man sieht gut, wie sich die Frequenz mit zunehmender Zahl erhöht. Summiert man den Wert jeder Harmonischen zusammen mit dem Gleichanteil zu jedem Zeitpunkt auf, so erhält man gerade den rekonstruierten Wert zu diesem Zeitpunkt.
Beispiel: Heizungsthermostat
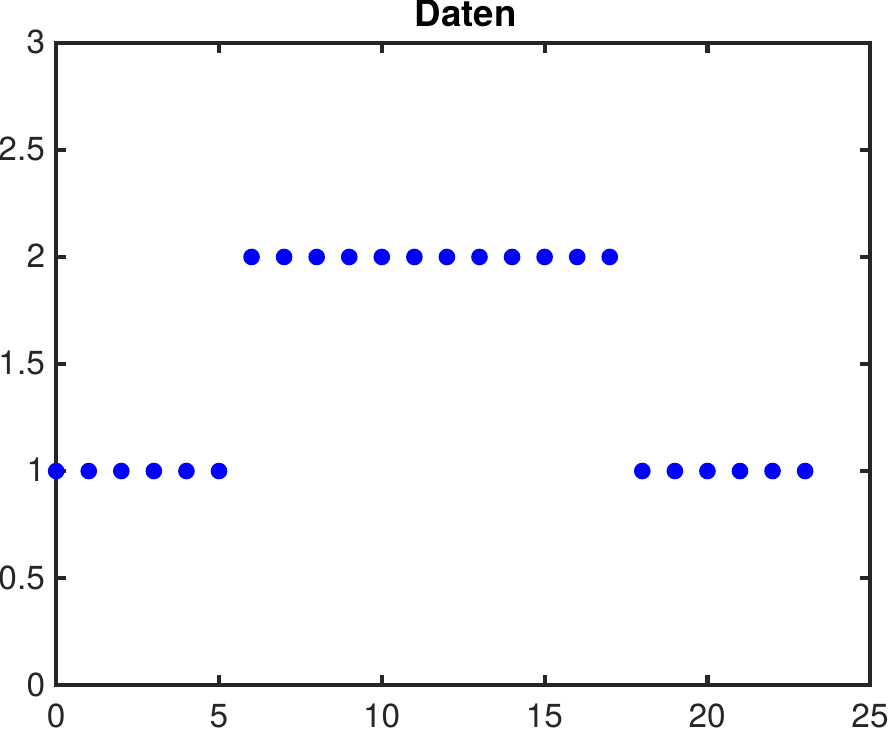
Nehmen wir an, dass eine Heizung so gesteuert wird, dass sie nachts 18° Cund tagsüber 21° Cerreichen soll. Dieses Schema kann man nun z.B. über stündliche Angaben wie in Abbildung 2.14 erreichen. Will man dies durch eine einzelne Funktion ausdrücken, so geht dies genauso wie bei dem Beispiel zuvor.
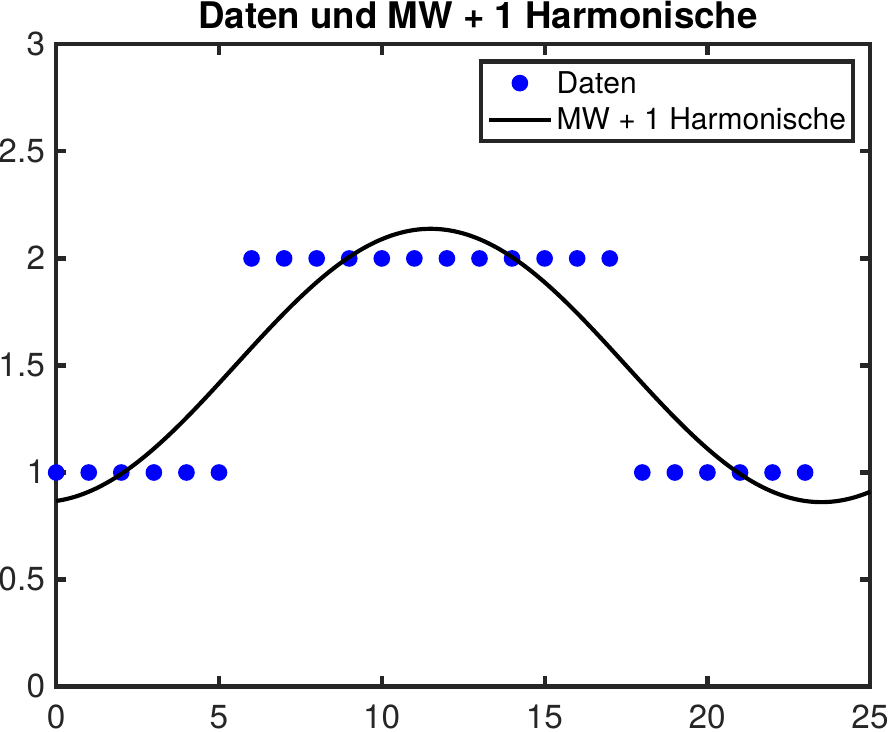
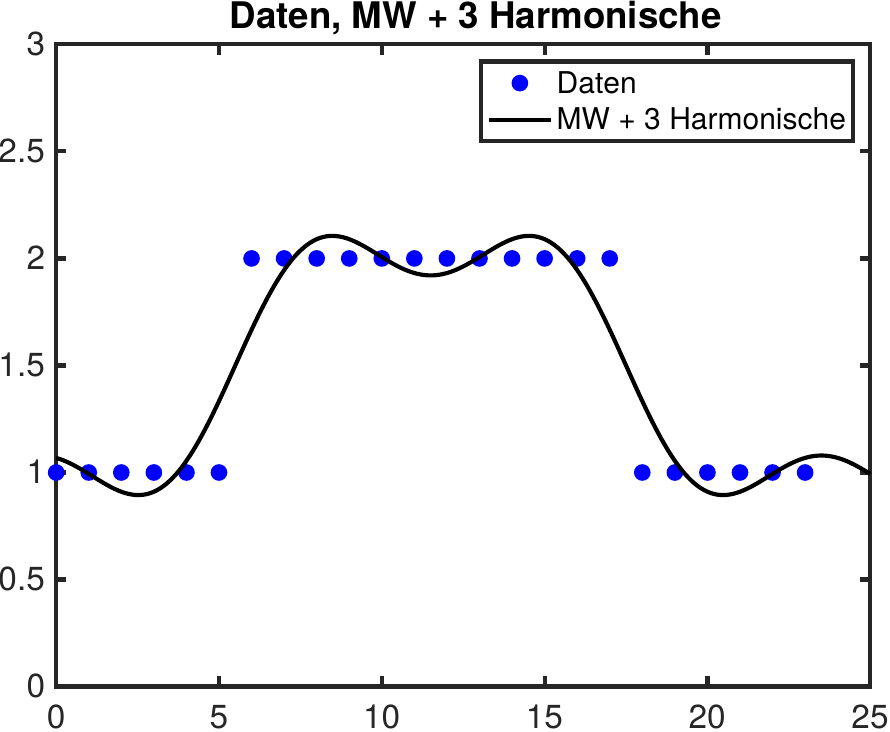
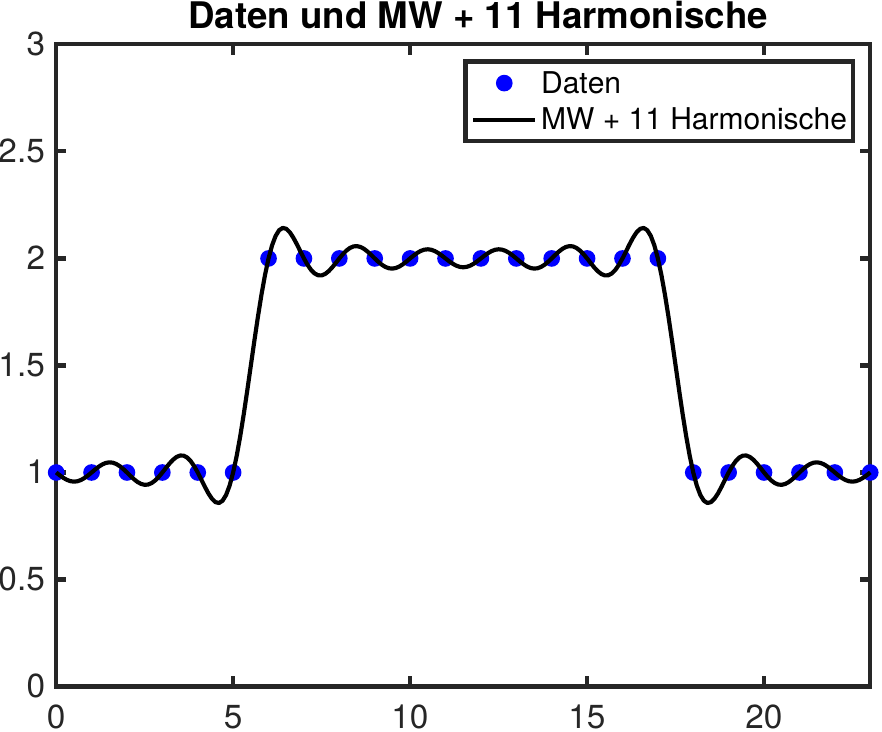
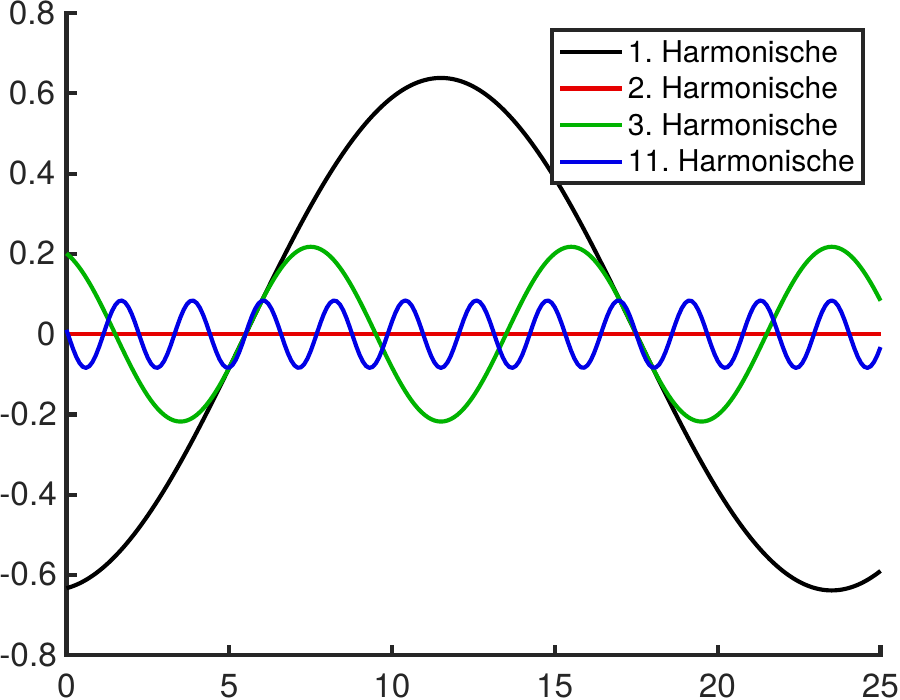
Schaut man sich auch hier einzelne Harmonische an (Abschnitt 2.16), so fällt auf, dass hier die geraden Harmonischen Null sind. In der spektralen Darstellung (Gleichung 2.3) bedeutet dies, dass alle Phasenwinkel \(\varphi_k=0\) sind, also keine Phasenverschiebung vorkommt. Zwischen den vorgegebenen Zeitpunkten (zwischen den vollen Stunden) entspricht das Ergebnis nicht unserer intuitiven Erwartung. Für diese Werte liegt aber keine Information vor, da die Synthese sicher nur 24 Werte exakt trifft (Abtasttheorem).
Beispiel: Jahresgang der Wassertemperatur
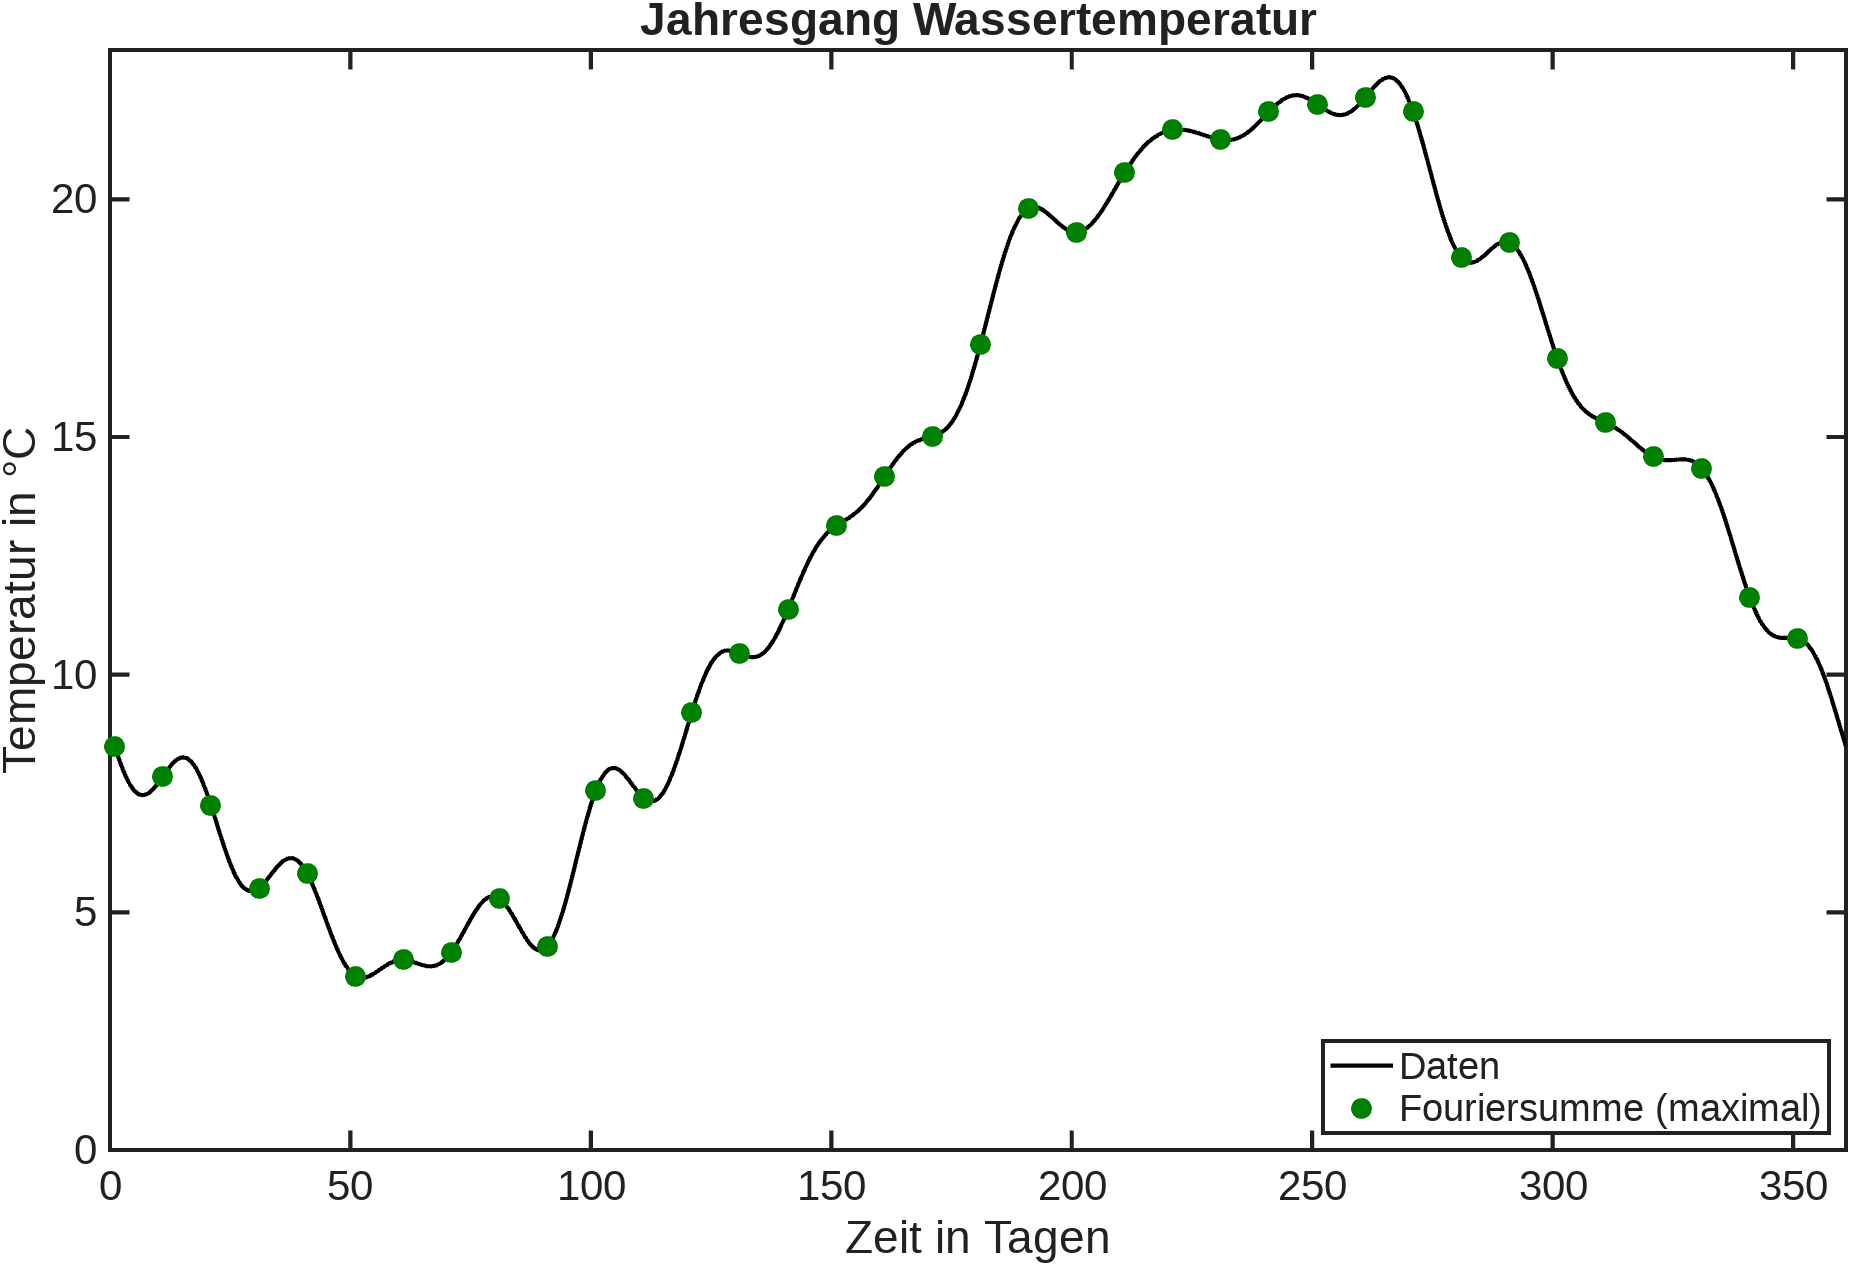
Zu Beginn haben wir in Abschnitt 2.2 eine Kosinusfunktion “von Hand” an die Daten der Wassertemperatur in der Nordsee angepasst. Wenn man dies mittels der Fourieranalyse durchführt, erhält man das Ergebnis in Abbildung 2.17. Man erkennt, dass die Messwerte durch die Fouriersynthese genau getroffen werden.
In der Literatur findet man folgende Notation: \(y_i=\beta_0+\beta_1\cdot x_i+\varepsilon_i\), \(i=1...n\) Hier entspricht \(\beta_0\) dem Parameter b und \(\beta_1\) dem Parameter m. Der Fehler der Abweichung der Geraden vom tatsächlichen Wert ist hier \(\varepsilon_i\), der normalverteilt ist. Die Parameter \(\beta_0\) und \(\beta_1\) heißen Regressionskoeffizienten.↩︎
Es gilt: \(\cos(x+y) =\cos x\cdot \cos y-\sin x\cdot \sin y\)
Ansatz: \(A\cdot \cos(x+\varphi) = A \cdot \cos x\cdot \cos \varphi- A \cdot\sin x\cdot \sin \varphi = a_1\cdot \cos x +b_1\cdot \sin x\)↩︎