21 Covid-19 Ausbreitung in Deutschland
Stand 14.10.2020
In diesem Kapitel wird ein erweitertes SIR-Modell (vgl. Kapitel 13), das eine Modifikation und Erweiterung des SIR-Modells von (Kermack und McKendrick 1927) darstellt, vorgestellt, das die Fallzahlen von Covid-19 in Deutschland reproduzieren soll. Dieses Modell ist in der Lockdown-Phase im März-Juni 2020 entstanden, als erst langsam Erkenntnisse zu dieser neuen Virusinfektion bekannt wurden. Covid-19 ist eine durch das Corona-Virus SARS-CoV-2 hervorgerufene Infektionskrankheit, die bis Stand Oktober 2020 nicht heilbar ist und gegen die es auch keinen Impfstoff gibt. Die Erkrankung verläuft in vielen Fällen harmlos bis symptomfrei, in einigen endet sie auch tödlich. Insbesondere ältere Menschen mit Vorerkrankungen sind gefährdet. Im vorliegenden Modell soll nun versucht werden mit einfachsten Mitteln die Fallzahlen zu reproduzieren. Daher werden weder eine Altersstruktur noch geographische Besonderheiten berücksichtigt. Die Bevölkerungszahl wird zudem als konstant angenommen (N).
Um dieses Ziel zu erreichen, muss man berücksichtigen, dass die gemeldeten Infiziertenzahlen nur einen (unbekannten) Bruchteil der tatsächlichen Fallzahlen darstellen. Deshalb wird eine zusätzlich Zustandsvariable, die Anzahl der nicht gemeldeten Infizierten U eingeführt. Im Gegensatz dazu ist nun I die Anzahl der gemeldeten Fälle.
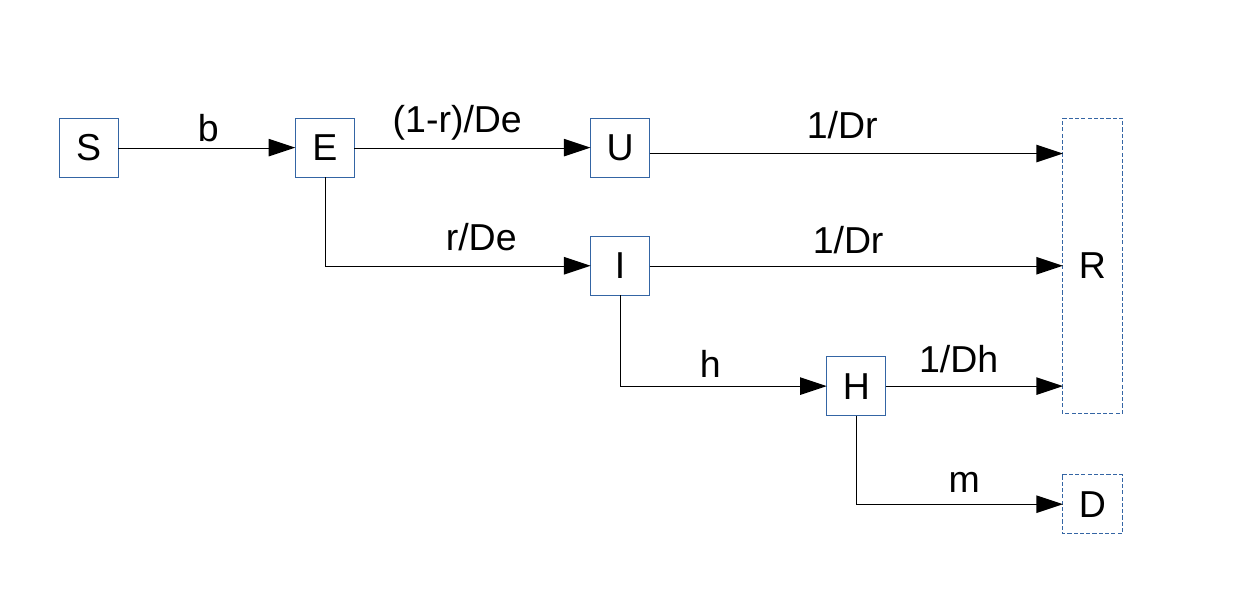
Das Modell beschreibt die zeitliche Entwicklung der Anzahl der anfälligen Personen (S, susceptible), der Infizierten, aber nicht infektiösen Personen (E, exposed) und der Anzahl der gemeldeten und nicht gemeldeten Infizierten (I, reported infectious ) (U, unreported infectious). Darüber hinaus werden Personen im Krankenhaus (H, hospitalized) berücksichtigt, die das Virus nicht weitergeben. Es werden keine Personen modelliert, die gesundet sind, da bisher die Fallzahlen so gering sind (Stand Juli 2020), dass keine Herdenimmunität und Sättigungseffekte auftreten.
Die Unterteilung in Infizierte (E) und Infektiöse (I und U) ist notwendig, um die zeitliche Verzögerung zwischen Infektion und Infektiosität zu berücksichtigen. Die Unterscheidung zwischen gemeldeten (I) und unentdeckten (U) Infizierten ist notwendig, um den tatsächlichen Epidemieverlauf abzubilden. Es wird davon ausgegangen, dass erkannte Infizierte nicht mehr zur Epidemie beitragen. Die Zahl der Neuinfektionen ist daher proportional zur Zahl der unentdeckten Infizierten und es gilt
Es wird davon ausgegangen, dass Personen, deren Infektion nicht erkannt wurde (U) nach einer Dauer \(D_r\) Tagen komplikationslos gesunden bzw. in Quarantäne gehen. Epidemiologisch kommt es hier nicht darauf an, dass die Personen gesunden (recover), sondern dass sie nicht mehr zum weiteren Infektionsgeschehen beitragen. Dasselbe gilt für dokumentierte Fälle (I). Vereinfachend wird davon ausgegangen, dass sie im Mittel nach \(D_r\) Tagen gesunden oder in Quarantäne gehen. Zusätzlich wird ein Teil der Fälle aufgrund der Schwere des Krankheitsverlaufs ins Krankenhaus eingewiesen. Es wird von einer Hospitalisierungsrate h (in 1/Tag) ausgegangen. Die Dauer der Hospitalisierung hängt vom Verlauf und der Schwere der Erkrankung ab und soll im Mittel ca. \(D_h\) Tage betragen. Hospitalisierte streben mit einer Mortalitätsrate m. Die Mortalitätsrate bezieht sich hier also auf hospitalisierte Personen und nicht auf die Gesamtbevölkerung. Das Modell ist in Abbildung 21.1 dargestellt.
Interessanterweise werden in Epidemiemodellen häufig keine Erkrankten modelliert. Dies liegt daran, dass eine Erkrankung an sich im allgemeinen kein Problem darstellt. Wichtig ist vielmehr die Infektiosität, die das Epidemiegeschehen maßgeblich beeinflusst. Bei Covid-19 werden alle erkannten Infizierten unter Quarantäne gestellt, so dass auch nur die unerkannten Fälle zum Infektionsgeschehen beitragen. Bei einer hohen Anzahl Infizierter kommt es dann letztlich auf die Zahl der verbleibenden Suszeptiblen an. Das ist hier noch nicht relevant.
Der Unterschied zum bekannten SIR-Modell besteht darin, dass durch die Berücksichtigung einer Latenzzeit die nicht-infektiösen Infizierten berücksichtigt werden. Dies ist strukturell im Modell wirksam, da es eine Verzögerung des Epidemieverlaufs nach sich zieht. Die Unterteilung in gemeldete und nicht gemeldete Fälle ist von Bedeutung, wenn die Modellergebnisse mit realen Fallzahlen verglichen werden sollen, um z.B. eine Vorhersage für die kommenden Monate zu erstellen. Für das Modell an sich ist dies unerheblich und könnte auch mit einer verringerten Transmissionsrate und einer auf die Gesamtinfiziertenzahl bezogenen Hospitalisierungsrate erreicht werden.
Zusätzlich wird berücksichtigt, dass vom 22. März 2020 bis 11. Mai 2020 strenge Maßnahmen wie z.B. eine Kontaktsperre verhängt wurden. In diesem Zeitraum wird die Transmissionsrate b mit dem Faktor \(f_m<1\) multipliziert. Anschließend wird ein linearer Anstieg bis zum \(f_a\)-fachen von b innerhalb von d Tagen angenommen.
Die Parametrisierung des Modells wurden teilweise grob aus den Angaben von (Heiden und Buchholz 2020) geschätzt und teilweise automatisch angepasst (hier nicht weiter erläutert). Alle Parameterwerte sind in Tabelle 21.1 angegeben.
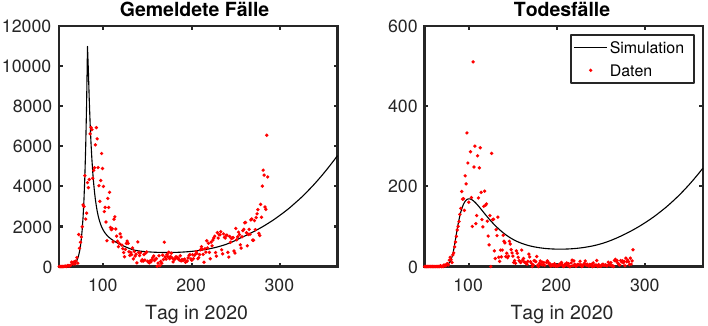
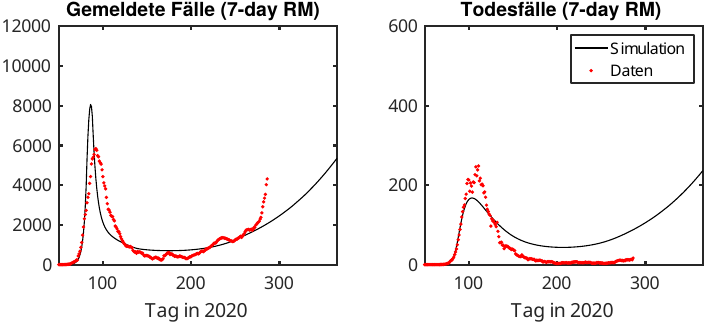
Die Simulationsergebnisse sind zusammen mit den Daten der Johns Hopkins Universität ((Systems Science und Engineering 2020)) in Abbildung 21.2 aufgetragen. Man sieht, dass die Fallzahlen anfänglich exponentiell ansteigen. Das Abflachen der realen Zahlen vor Beginn der Maßnahmen am 22. März beruht vermutlich auf einer bereits einsetzenden Verringerung der Transmissionsrate. Die Bevölkerung hat bereits vor den gesetzlichen vorgeschriebenen Maßnahmen ihre Kontakte und die Ansteckungswahrscheinlichkeit durch Hygienemaßnahmen verringert. So verkleinert sich die Transmissionsrate, was hier im Modell nicht abgebildet ist. Die Zahl der Todesfälle schwankt in der Realität recht stark (Abbildung 21.2, rechts). Dies ist u.a. eine Folge der Meldeverzögerung. Krankenhäuser, Pflegeeinrichtungen und Gesundheitsämter melden in der Regel nicht am Wochenende, so dass die Daten meistens einen 7-Tage-Zyklus aufweisen, den das Modell nicht abbilden kann. Man vergleicht daher auch besser die sogenannten laufenden Mittelwerte (running mean, moving mean) der Daten und der Simulationsergebnisse, um die Kurven zu glätten. Hierbei werden zu jedem Tag die Daten der letzten 7 Tage gemittelt und als Wert des aktuellen Tages aufgetragen. Dies ist in Abbildung 21.3. dargestellt. Das Modell kann den generellen Verlauf der sogenannten ersten Welle und den Beginn der zweiten Welle abbilden. Die Todesfallzahlen der ersten Welle werden unterschätzt, später überschätzt. Dies liegt vermutlich daran, dass das Modell die Optimierung der Behandlung nicht und die Altersverteilung der Erkrankten nicht abbildet. Die Unterschätzung der zweiten Welle kann noch nicht abschließend diskutiert werden.